BM25 wins at scale
BM25 Wins at Scale: A Scaling Study of Retrieval-Augmented Generation Paradigms, arXiv, 2026.
RAG에는 lexical retrieval, dense retrieval, graph-based RAG, agentic search 등 여러 paradigm이 있어요. 각 방법은 보통 자기 benchmark에서 하나의 corpus 크기로 평가돼요. 그래서 corpus가 커질 때 정확도와 비용이 어떻게 변하는지는 알기 어려웠어요. 이 논문은 질문과 정답 근거를 고정한 채 corpus만 약 450배 키우면서 7개 pipeline을 같은 조건으로 비교해요.
핵심 결과는 corpus 크기에 따라 순위가 바뀐다는 점이에요. 작은 corpus에서는 file-system 도구로 탐색하는 agent가 앞서지만, 약 10M token을 넘으면 BM25가 역전하고 full corpus에서는 약 20점 차이로 앞서요. 저자들은 이 차이가 agent의 추론 능력이 아니라 corpus 전체에서 후보를 찾는 능력(candidate discovery)에서 생긴다고 분석해요.
질문과 근거는 고정하고 background corpus만 키운다
실험에는 EnterpriseRAG-Bench를 사용해요. LLM inference 서비스를 운영하는 가상의 회사를 모델링한 benchmark예요. Wiki, chat thread, ticket, e-mail, 회의록, CRM, code review 등 9개 source에서 온 511,957개 문서(600.8M token)에 회사 개요 페이지 2개를 scaffold로 더해 총 511,959개 문서를 써요. 질문은 단순 조회부터 completeness, conflicting-information, high-level 질문까지 10가지 유형으로 500개이고, 질문마다 gold 문서, gold answer, atomic answer fact가 붙어 있어요. 전체 문서의 7.7%는 잘못된 경로에 저장되거나 오래된 사실을 담은 near-duplicate인 noise 문서예요.
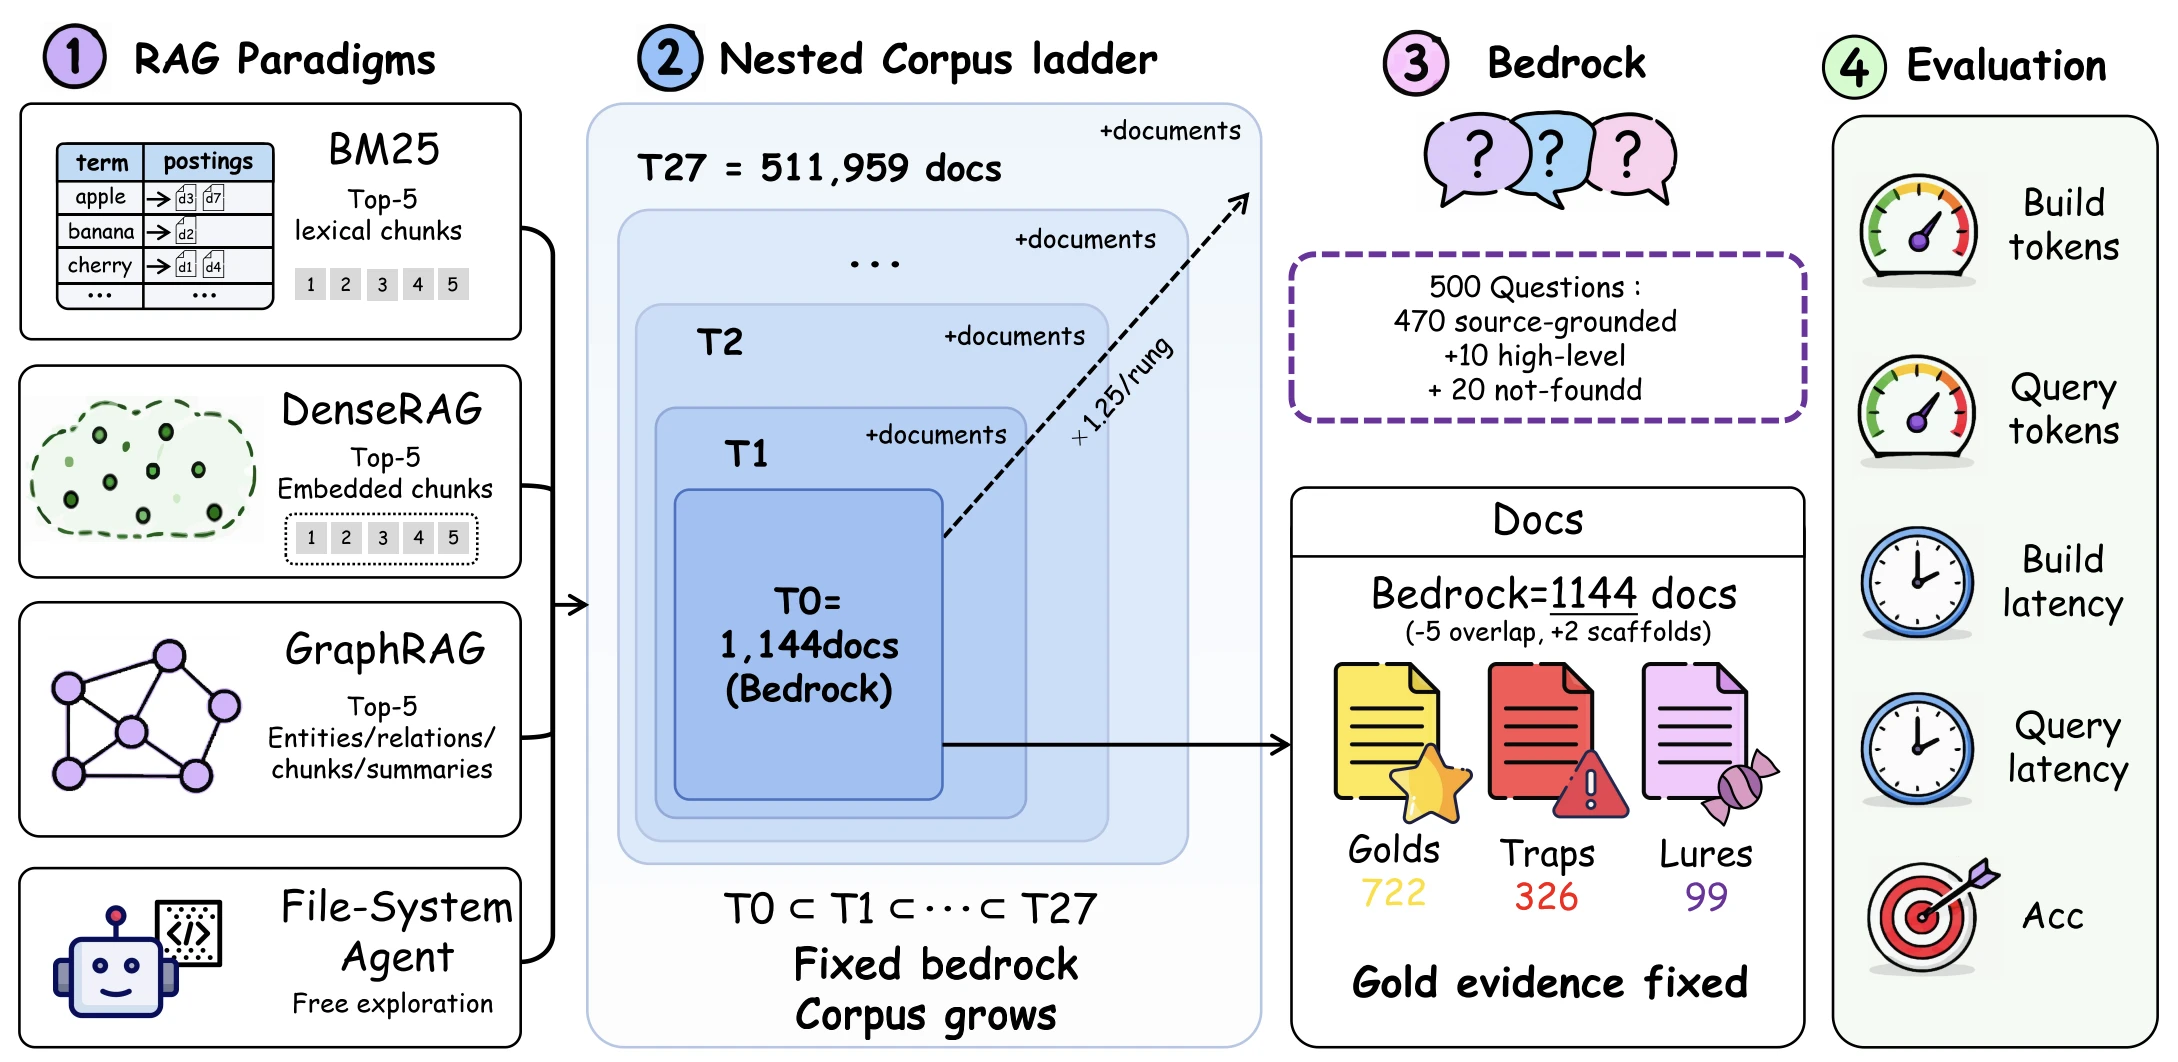 Figure 2
가장 작은 tier인 bedrock은 아래 문서들로 구성돼요. 722개 gold 문서, 326개 trap, 99개 lure, 2개 scaffold를 합치고 중복 5개를 빼면 1,144개예요.
- Trap은 gold 문서와 같은 entity나 topic을 다루지만 version, 날짜, 결정 내용이 틀린 문서예요. BM25 top-10과 dense reranking top-10으로 후보를 모은 뒤 LLM filter로 골라요.
- Lure는 not-found 질문을 위한 문서예요. 질문과 가장 비슷하지만 답은 들어 있지 않은 문서를 질문당 5개 넣어서, 검색 결과가 비었다는 이유만으로 “모른다”고 답하는 경우를 막아요.
Trap과 lure는 처음부터 bedrock에 들어 있어요. 따라서 corpus가 커져도 질문별 근거와 adversarial set은 그대로이고, 늘어나는 것은 background 문서뿐이에요.
나머지 문서는 source와 noise 비율을 유지하는 순서 $\pi$로 한 번 섞고, 앞에서부터 잘라 bedrock에 붙여요. Tier 크기는 단계마다 1.25배씩 늘어나요.
\[T_0 \subset T_1 \subset \cdots \subset T_{27}, \quad n_{t+1} \approx 1.25\, n_t\]이렇게 1,144개(1.7M token)부터 511,959개(600.8M token)까지 28개 tier를 만들어요. 모든 tier가 엄격하게 포함 관계를 이루므로 index를 이전 tier에서 이어서 확장할 수 있고, tier 사이의 추가 구축 비용도 측정할 수 있어요. 문서 길이가 source마다 달라서 scale은 문서 수가 아닌 corpus token으로 표기해요.
7개 pipeline을 하나의 reader와 judge로 비교한다
비교 대상은 4개 paradigm에 속한 7개 pipeline이에요.
- BM25는 LLM 없이 만든 inverted index로 검색해요. [참고]
- DenseRAG는 chunk embedding으로 dense retrieval을 해요. [참고]
- HippoRAG는 triple graph를 만들고 query를 fact에 연결한 뒤 Personalized PageRank로 검색해요. [참고]
- MS-GraphRAG는 entity graph와 계층적 community report를 만들고 local search mode로 답해요. [참고]
- LightRAG는 entity와 relation의 dual-level index를 만들고 hybrid mode로 답해요. [참고]
- LinearRAG는 NER과 embedding만으로 entity co-occurrence graph를 만들어요. [참고]
- File-System Agent는 index 없이 질문당 80번의 LLM call 예산 안에서 원본 file tree를 탐색해요.
모든 pipeline은 같은 reader인 Qwen3.6-27B(temperature 0, thinking off)를 쓰고, File-System Agent도 같은 모델을 policy로 써요. Embedding은 Qwen3-Embedding-0.6B를 공유해요. Retrieval depth가 있는 방법은 모두 top-5 chunk를 쓰고, BM25, DenseRAG, HippoRAG는 같은 1,200-token chunk를 공유해요.
채점은 benchmark의 공식 protocol을 따라요. Judge가 답이 gold answer와 맞는지(aligned)를 판정하고, atomic fact 중 답에 포함된 비율로 completeness를 계산해요. 최종 점수는 정답일 때만 completeness를 인정해요.
\[\text{combined}(q) = \begin{cases} \text{completeness}(q), & \text{aligned}(q) = 1 \\ 0, & \text{aligned}(q) = 0 \end{cases}\]신뢰구간은 질문을 10,000번 bootstrap resampling해서 구해요.
약 10M token에서 BM25가 File-System Agent를 역전한다
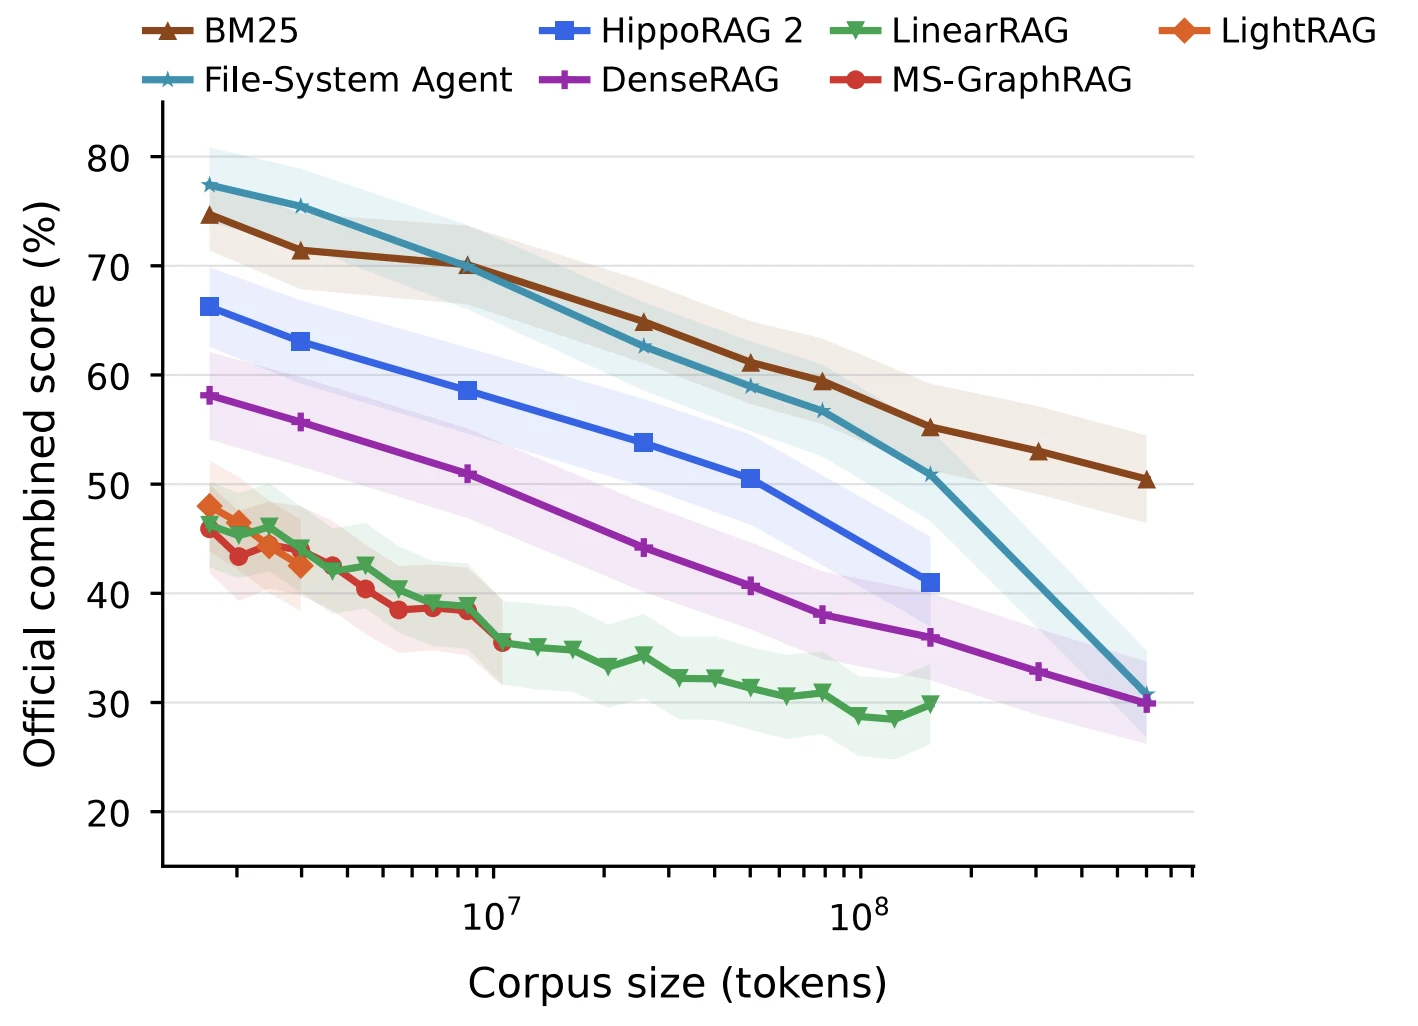 Figure 3
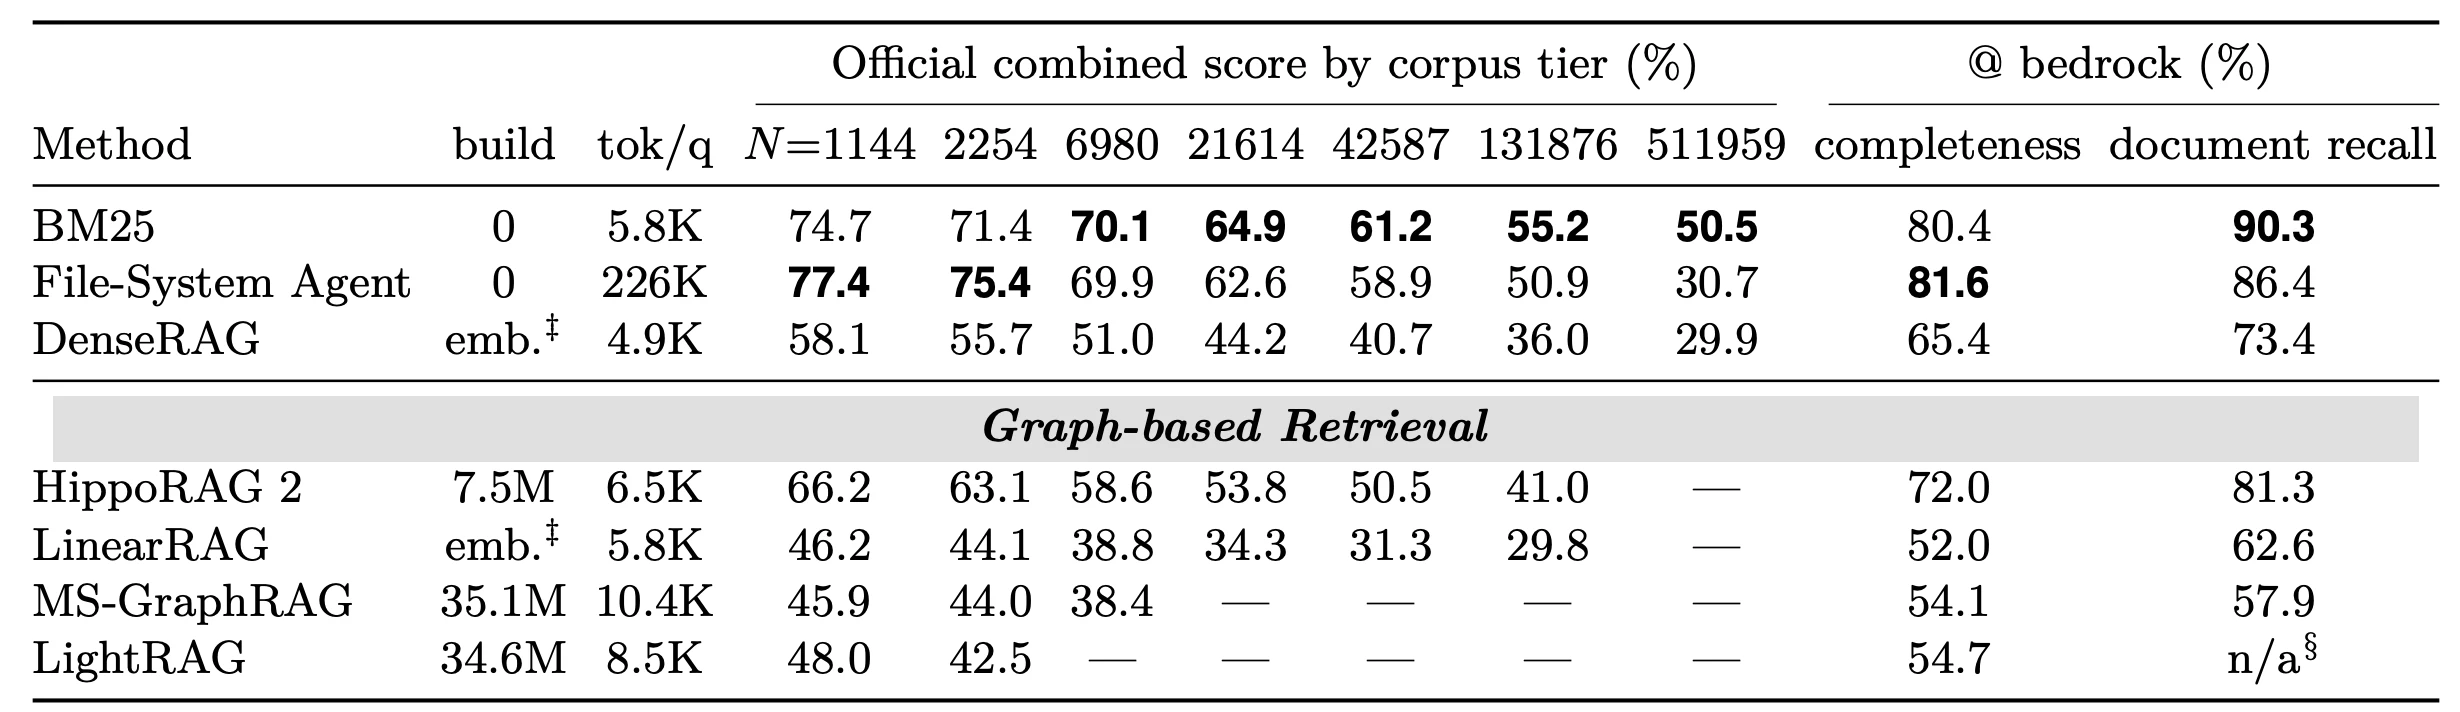 Table 1
과 Figure 3은 corpus 크기에 따라 순위가 바뀌는 crossover를 보여줘요.
- Bedrock에서는 File-System Agent가 77.4, BM25가 74.7이에요.
- 약 10M corpus token 부근에서 두 곡선이 교차하고, 그 이후 모든 공유 tier에서 BM25가 앞서요.
- Full corpus(601M token)에서 BM25는 50.5, File-System Agent는 30.7, DenseRAG는 29.9예요.
Bedrock 대비 하락폭을 계산해 보면 차이가 더 분명해요. BM25는 24.2점, DenseRAG는 28.2점, File-System Agent는 46.7점 떨어져요. 80번의 LLM call을 쓰는 반복 탐색이 한 번의 global lexical ranking보다 corpus 증가에 더 취약하다는 뜻이에요.
Graph 계열 중에서는 HippoRAG가 bedrock 66.2로 가장 높지만, 측정된 모든 tier에서 BM25보다 낮아요. 나머지 graph 방법은 bedrock부터 50점 아래에 있어요. Graph 방법은 중간 tier에서 곡선이 끝나는데, HippoRAG와 LinearRAG는 131,876개, MS-GraphRAG는 8,750개, LightRAG는 2,254개 문서까지만 index를 만들었어요. 저자들은 만들지 못한 tier를 main curve에서 0점으로 처리하지 않고 빈칸으로 남겨요. 큰 scale에서 graph 방법의 결과는 정확도보다 구축 가능성의 문제라는 입장이에요.
Graph RAG는 index 구축에서 먼저 막힌다
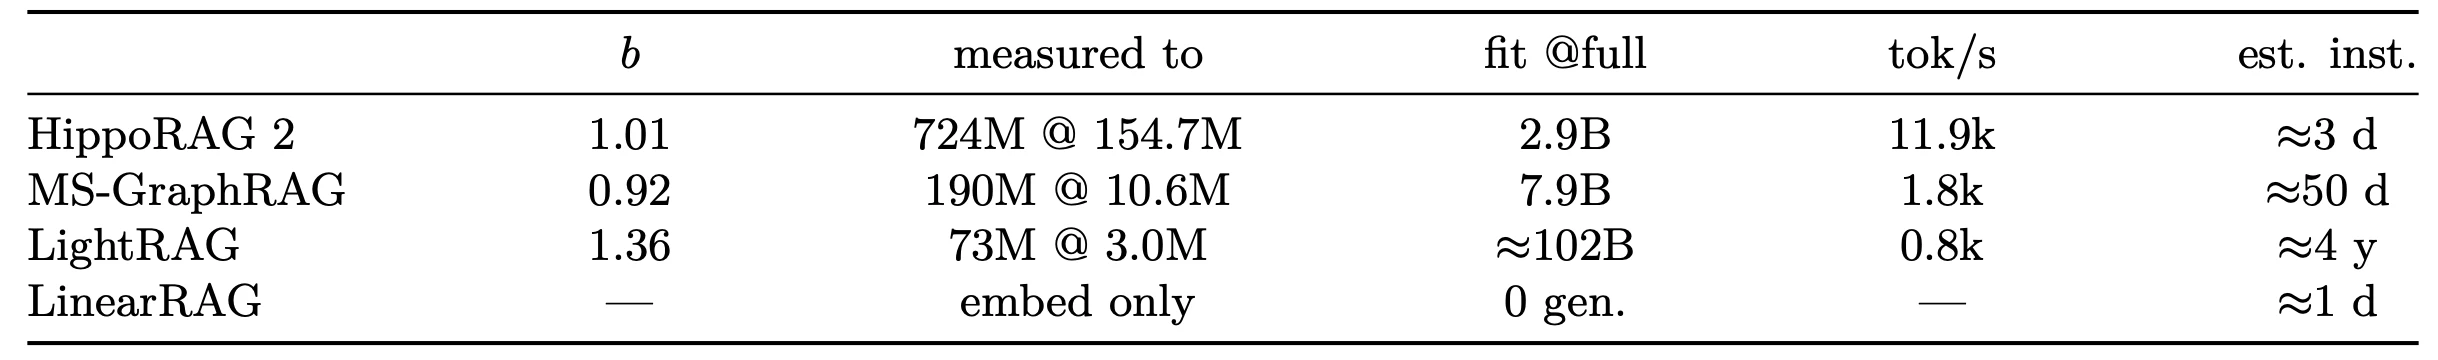 Table 2
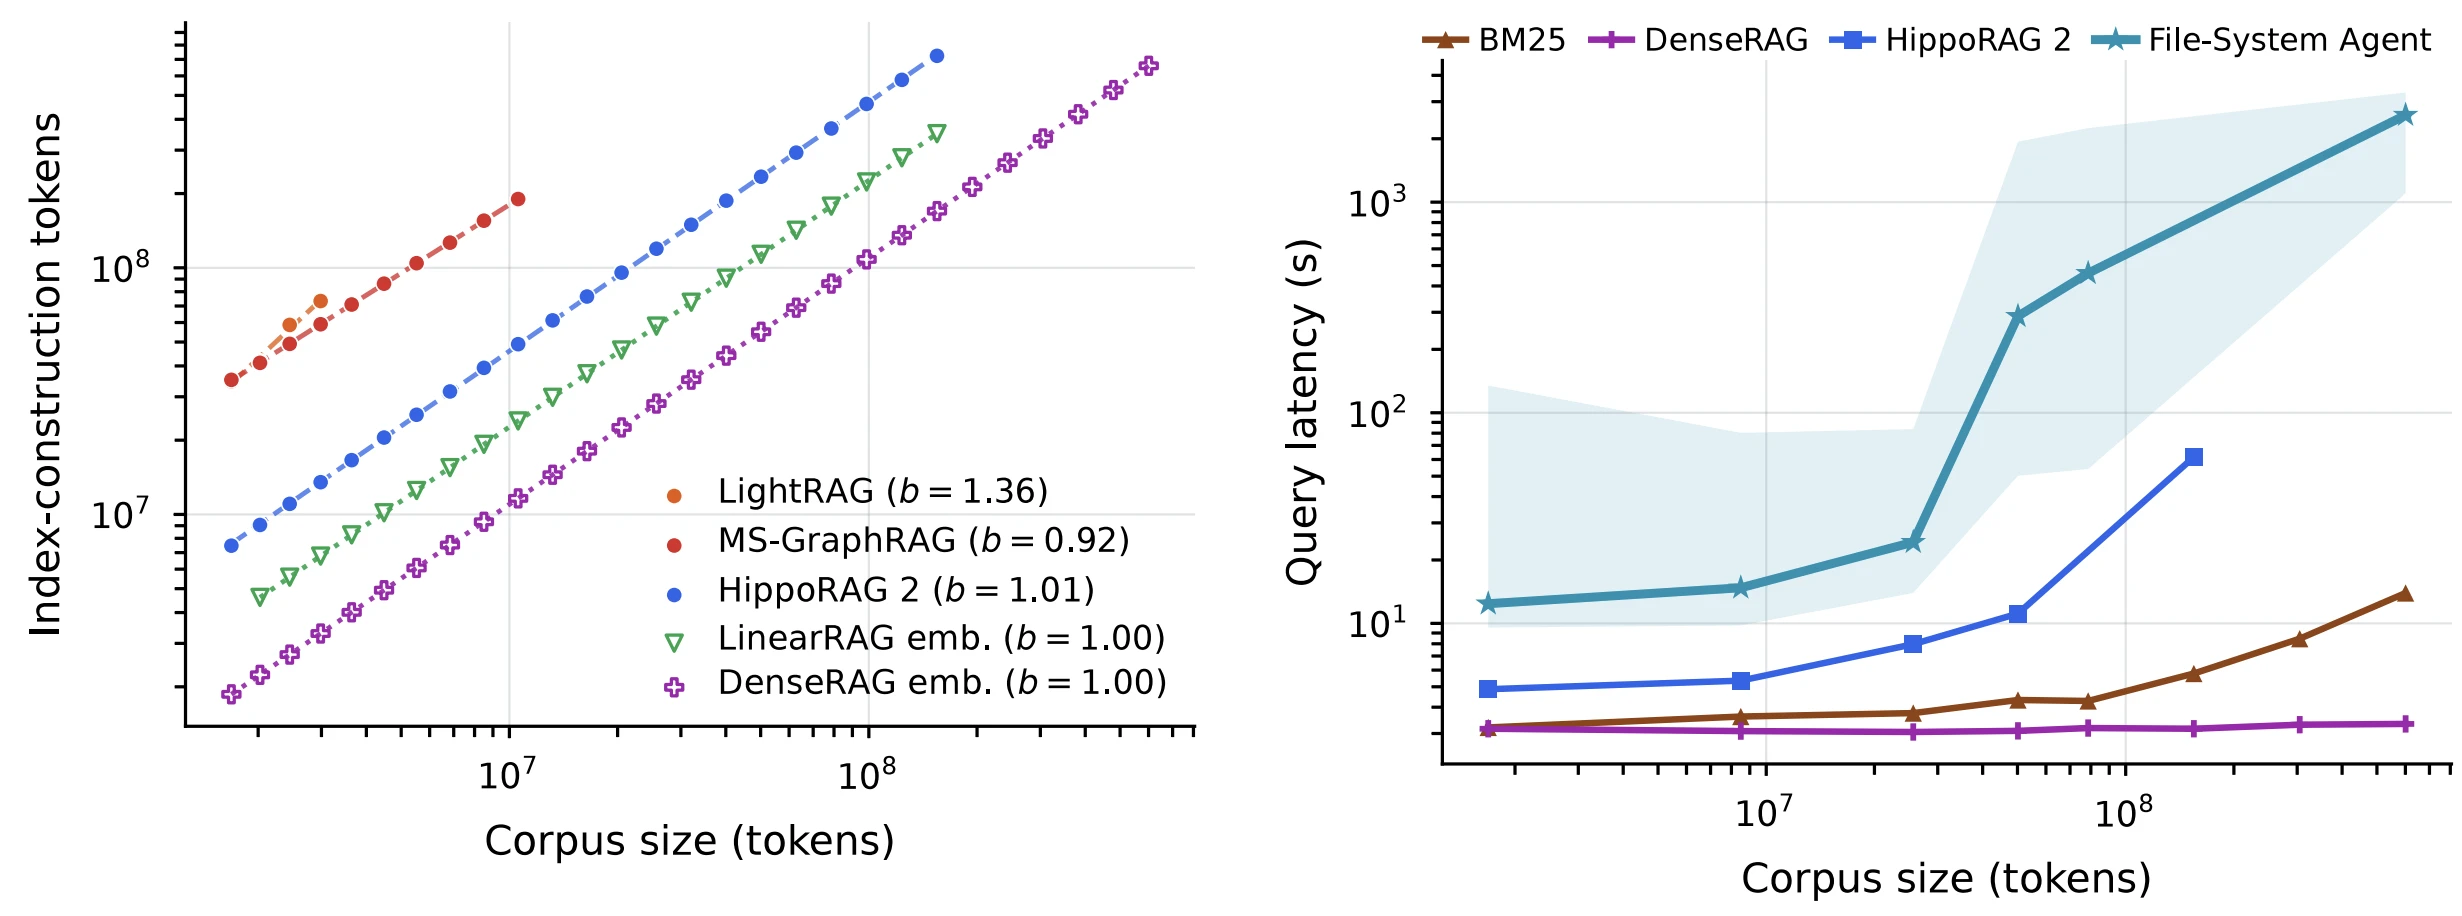 Figure 4
Graph 방법은 index를 만들 때 모든 chunk에 LLM을 호출해야 해요. 그래서 corpus가 커질수록 구축 비용이 함께 늘고, 실험에서도 full corpus까지 index를 완성한 graph 방법은 없어요. 저자들은 완성한 tier까지의 구축 비용 추세를 바탕으로 full corpus에 필요한 비용을 추정해요. Figure 4 왼쪽은 tier별 구축 token을, Table 2는 full corpus 추정치를 보여줘요.
File-System Agent는 query마다 비용을 낸다
Figure 4 오른쪽은 query latency를 보여줘요. One-shot pipeline은 query 비용이 corpus 크기와 거의 무관해요. BM25, DenseRAG, HippoRAG는 질문당 각각 5.8K, 4.9K, 6.5K token을 쓰고, 대부분이 reader prompt예요.
File-System Agent는 bedrock에서 질문당 226K token으로 BM25의 39배이고, $N = 21{,}614$에서는 343K token으로 60배까지 늘어요. LLM call 수의 중앙값도 5에서 8로 늘어요. 80-call 예산을 다 쓰는 비율은 $N = 42{,}587$까지 7% 미만이지만, $N = 131{,}876$에서 15%, full corpus에서 31%로 올라가요. 다만 예산 안에서 끝난 질문의 정확도도 함께 떨어지므로, 성능 하락을 예산 부족만으로 설명할 수는 없어요.
정확도와 비용을 함께 보면 BM25가 Pareto frontier에 있다
구축 비용과 query 비용을 합쳐 500개 질문 기준으로 환산하면 BM25는 2.9M token으로 74.7점을 얻고, File-System Agent는 112.8M token으로 77.4점을 얻어요. 약 39배의 token으로 2.7점을 더 얻는 셈이에요. HippoRAG는 10.7M token에 66.2점이고, MS-GraphRAG와 LightRAG는 약 40M token을 쓰고도 다른 방법에 dominated돼요. 구축 비용을 10개에서 10,000개 질문까지 어떻게 나눠도 BM25는 Pareto frontier 위에 있어요.
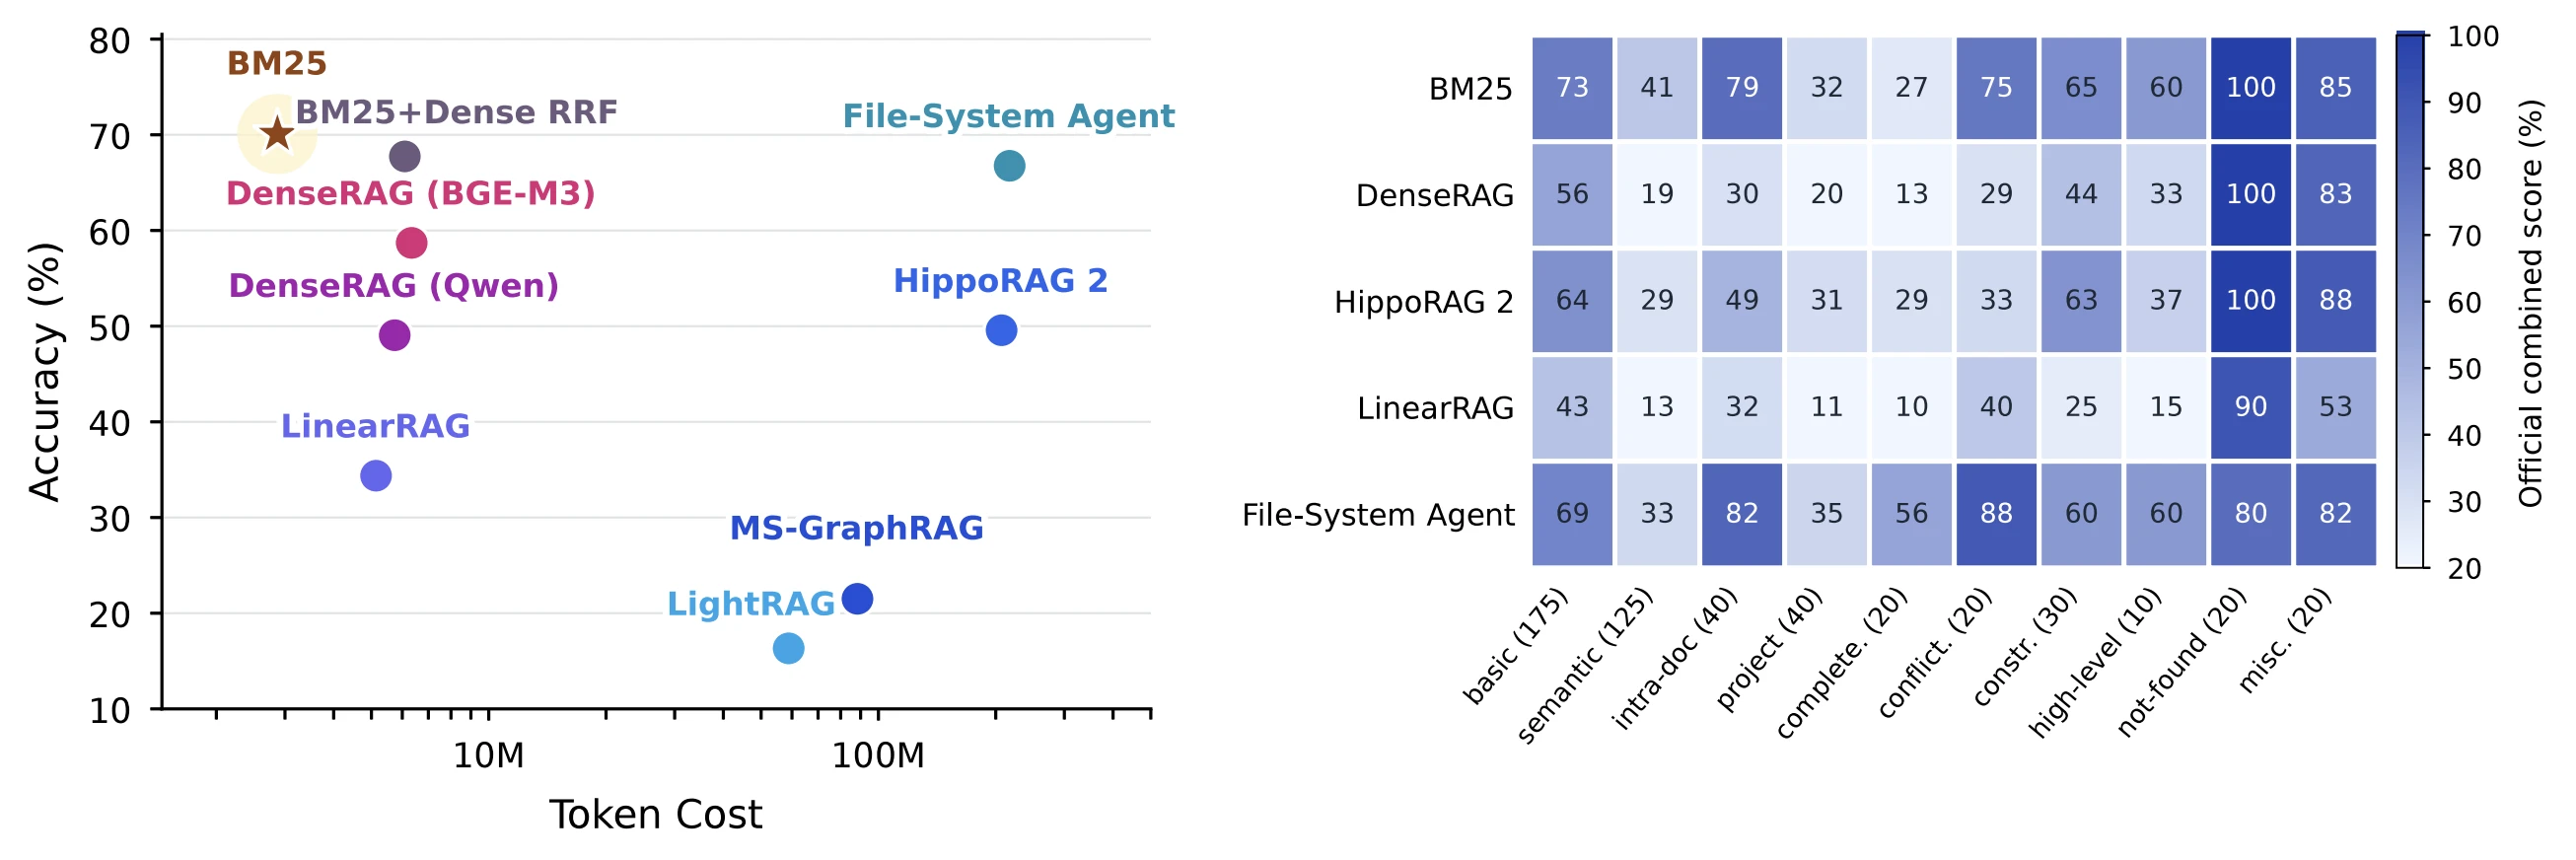 Figure 5
위 비교는 bedrock 한 지점의 결과예요. Figure 5 왼쪽은 같은 비교를 6개 tier로 넓혀요. 같은 150개 질문으로 측정하고, 가로축은 tier별 구축 비용과 query 비용의 평균, 세로축은 tier별 정확도의 평균이에요. 이때 graph 방법이 index를 만들지 못한 tier는 0점으로 계산해요. 예를 들어, 구축이 정해진 계산 자원 한도를 넘거나, entity 추출이나 merge 도중 실패하거나, 완성된 index가 일부 질문에 답할 수 없는 경우를 구축 실패로 봐요. Main curve는 index를 만든 tier의 점수만 보여주므로 구축 실패가 정확도에 드러나지 않는데, 이 요약은 구축 실패까지 반영해서 실제 규모에서 쓸 수 있는지를 보여줘요.
질문 유형에 따라 강점이 갈린다
Figure 5 오른쪽은 $N = 42{,}587$에서 질문 유형별 점수를 보여줘요.
- File-System Agent는 intra-document, project-related, completeness, conflicting-information 질문에서 BM25보다 높아요. 특히 completeness 질문에서는 56점 대 27점으로 차이가 커요. 여러 문서를 모아야 하는 질문에서 반복 탐색이 유리하다는 뜻이에요.
- BM25는 나머지 5개 유형에서 가장 높거나 동률이에요.
- Not-found 질문의 점수는 주로 답변을 거절하는 능력을 측정해요. One-shot reader는 근거가 없으면 답을 거절하지만, 반복 탐색하는 agent는 근거 없는 답을 내놓는 경우가 있어요.
- Graph 방법은 miscellaneous 유형에서만 1위예요. 이 유형은 업무와 무관한 잡담이나 정리되지 않은 경로에 저장된 비공식 문서를 묻는 질문이에요.
Agent의 문제는 추론이 아니라 후보 발견이다
File-System Agent가 큰 corpus에서 무너지는 원인을 찾기 위해, 저자들은 retrieval 도구만 바꾼 Agent+BM25를 만들어요. 모델, harness, 80-call 예산, judge는 그대로 두고 raw-file 도구를 ranked BM25 search와 chunk 읽기 도구로 바꿔요. 첫 검색은 원래 질문을 그대로 쓰도록 강제해서, 첫 top-5가 Native BM25와 정확히 같도록 해요. 실험은 bedrock과 full corpus에서 같은 150개 질문으로 진행해요.
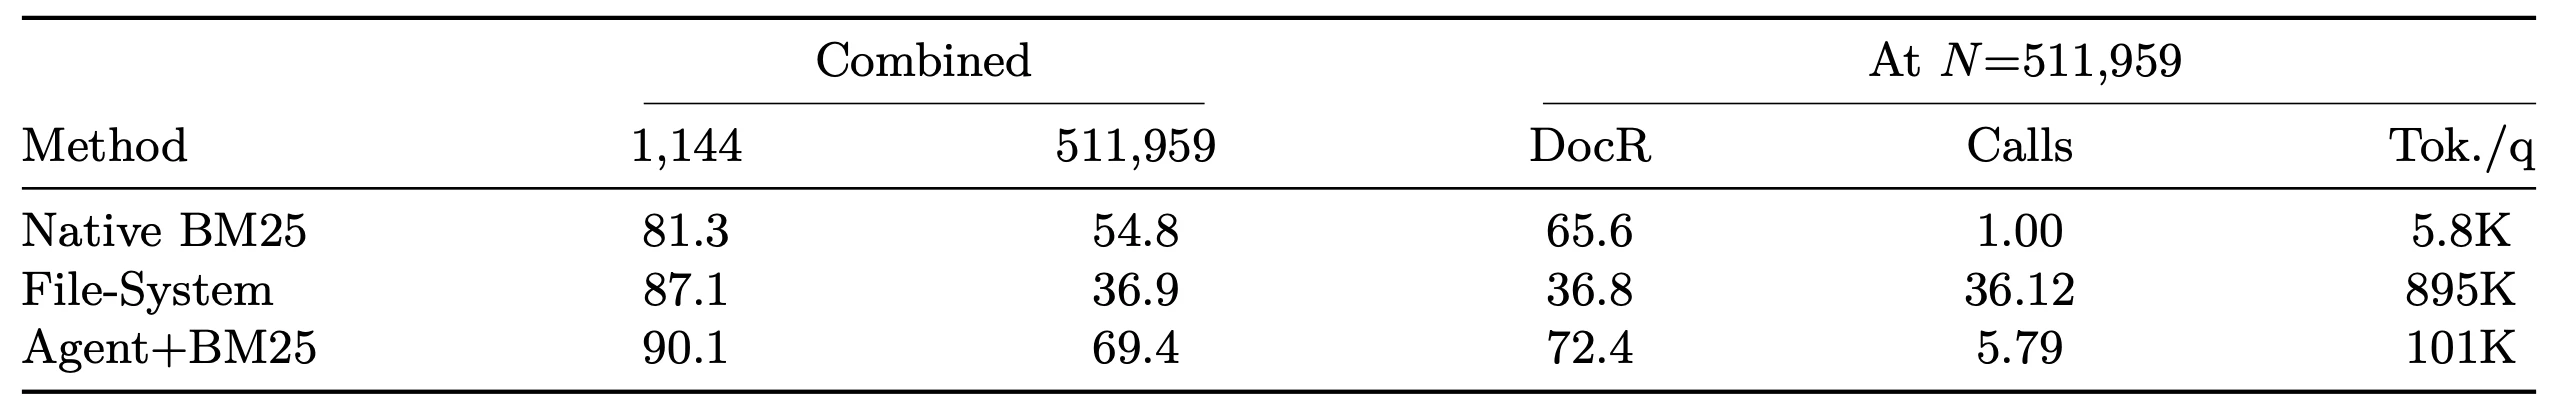 Table 4
- Bedrock에서 Native BM25는 File-System Agent보다 5.73점 낮아요.
- Gold 문서를 하나라도 찾은 질문만 보면 File-System Agent가 85.9점으로 BM25(73.8점)보다 높아요. 하지만 gold 문서를 찾는 비율 자체가 39.0%로, BM25의 71.6%보다 크게 낮아요.
즉 agent는 근거를 찾으면 잘 답하지만, 큰 corpus에서 근거를 찾지 못해요. Retrieval 도구만 바꾼 Agent+BM25는 full corpus에서 69.4점을 기록해요. File-System Agent보다 32.52점, Native BM25보다 14.56점 높아요. Gold 문서 발견 비율은 78.0%로 오르고, 질문당 LLM call은 36.12번에서 5.79번으로, token은 895K에서 101K로 줄어요. 정확도를 높이면서 비용은 약 1/9로 줄인 거예요.
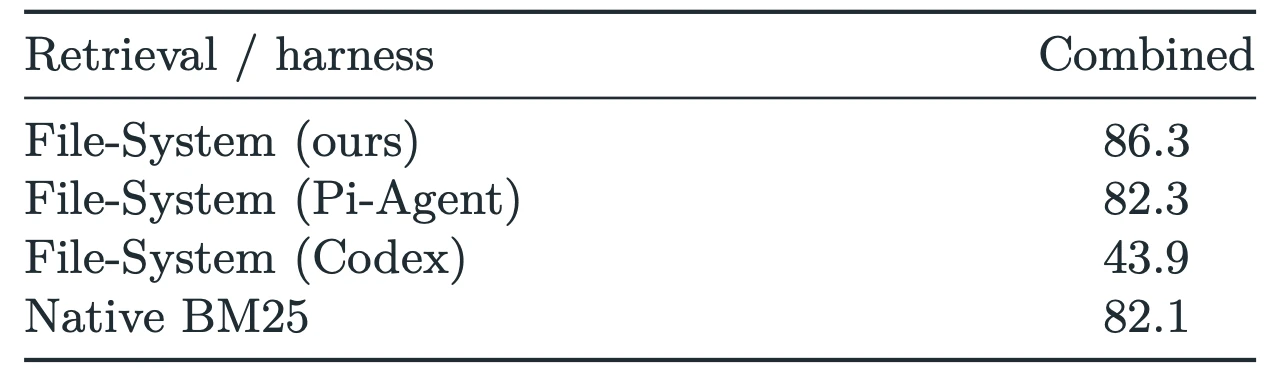 Table 5
Harness 구현에 따른 차이도 확인해요. Bedrock에서 같은 모델과 같은 corpus로 harness만 바꾸면 이 논문의 harness가 86.3점, Pi-Agent가 82.3점, Codex harness가 43.9점이에요. Harness 선택이 결과에 크게 영향을 준다는 점을 보여주고, 동시에 Agent+BM25가 가장 강한 raw-file agent와 비교됐다는 점도 확인해 줘요.
같은 graph index도 agent가 쓰면 결과가 달라진다
File-System Agent의 결과에는 agent라는 요소와 raw file이라는 저장소 요소가 섞여 있어요. 이를 분리하기 위해 저자들은 graph index를 typed read-only 도구로 노출해요. Semantic search, neighborhood expansion, Personalized PageRank, chunk 읽기와 각 방법의 native one-shot ranker를 도구로 제공하고, agent는 raw file에 접근하지 못해요.
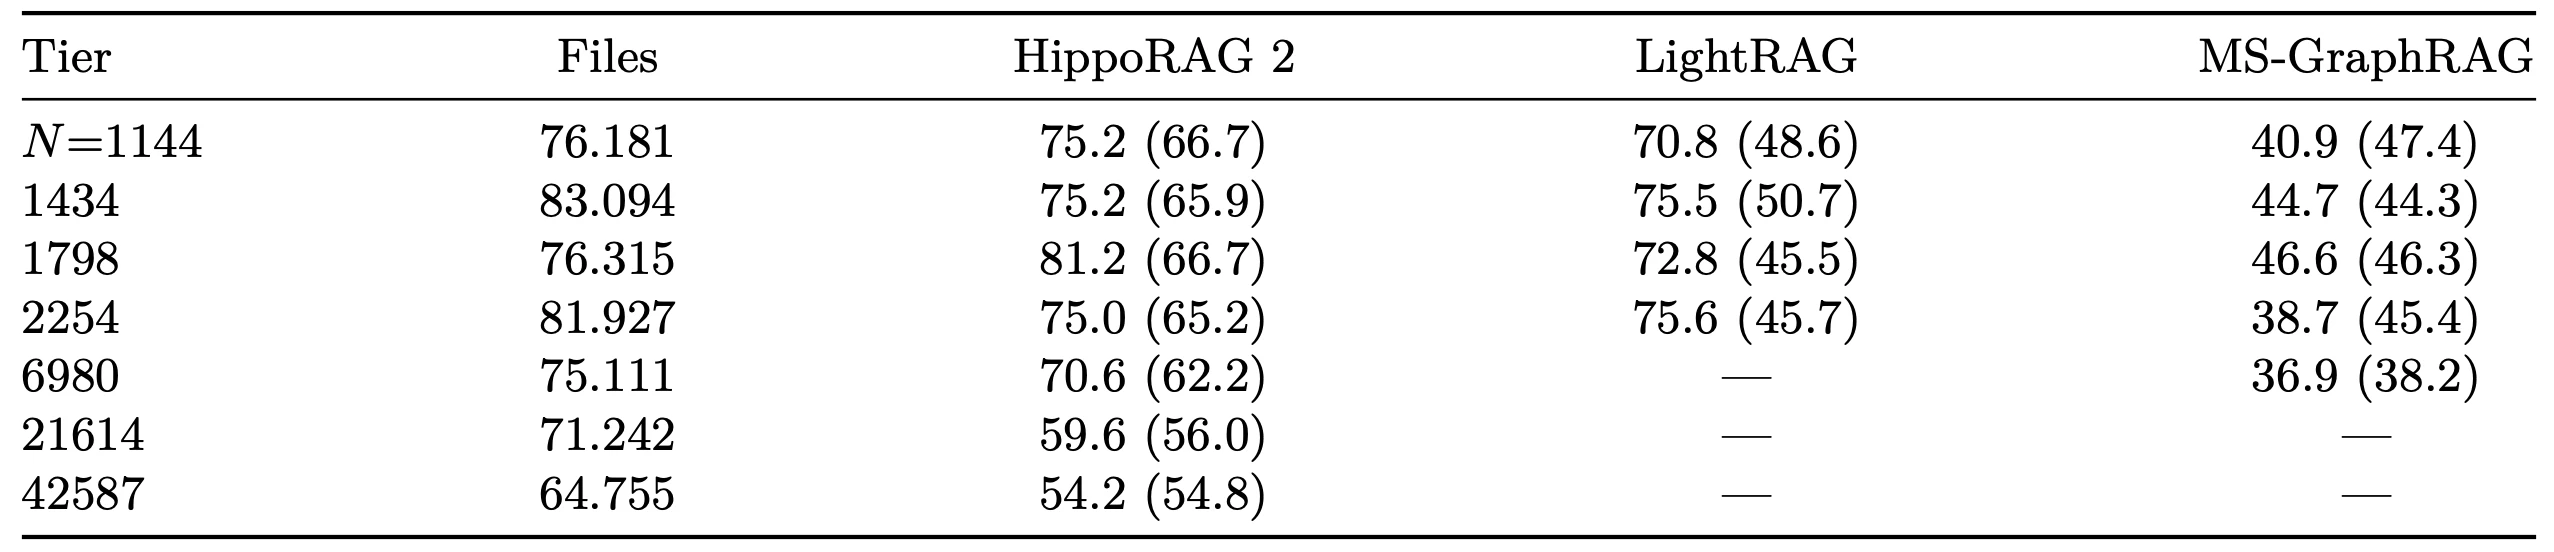 Table 3
- LightRAG는 agent로 접근할 때 4개 tier에서 22.2–29.9점 올라요. Index 자체에는 쓸 만한 정보가 있지만 native hybrid ranker가 이를 잘 꺼내지 못한다는 뜻이에요.
- HippoRAG는 7개 tier에서 −0.6–14.5점 변해요. Table 3을 tier 순서로 보면, bedrock에서 +8.5점이던 개선폭이 $N = 21{,}614$에서 +3.6점, $N = 42{,}587$에서 −0.6점으로 줄어요. Graph 위의 agent도 corpus가 커지면 이점이 사라지는 경향을 보여요.
- MS-GraphRAG는 5개 tier에서 −6.7–0.4점으로 거의 변화가 없거나 오히려 낮아져요.
같은 index라도 one-shot ranker로 쓰느냐 agent로 쓰느냐에 따라 결과가 크게 달라져요. 이 결과는 graph RAG 논문들의 성능 비교가 index 품질과 query 방식을 함께 측정하고 있다는 점을 보여줘요.
BM25는 왜 이 benchmark에서 강할까
저자들은 질문과 trap의 성격에서 이유를 찾아요.
- Enterprise 질문에는 제품명, ticket 번호, 프로젝트명 같은 정확한 단어가 들어 있어요. 이런 lexical anchor가 있으면 단어 매칭만으로 정답 문서를 찾기 쉬워요.
- Trap은 정답과 같은 주제지만 사실이 틀린 문서예요. 의미가 비슷한 문서를 가져오는 dense retrieval과 graph retrieval은 trap도 함께 가져오지만, 식별자를 정확히 맞추는 BM25는 trap을 더 잘 걸러요. 여기에 scale 측면의 이유가 더해져요. BM25는 corpus 전체에 대한 순위를 index로 미리 준비해 두고 query마다 같은 비용으로 재사용해요. 반면 File-System Agent는 tree를 순차 탐색하므로 corpus가 커질수록 정답에 도달하기 어려워져요.
Graph 방법은 두 조건 모두에서 불리해요. Entity 이웃을 따라가는 검색은 같은 주제의 trap을 가져오기 쉽고, LLM extraction은 noise를 더해요. Bedrock에서 추출된 32K개 entity에는 잘못 잘린 조각이 섞여 있고, HippoRAG는 graph edge에 관계의 의미를 남기지 않아서 (Project, released_in, Q3)와 (Project, delayed_to, Q3)를 graph 탐색 단계에서 구분하지 못해요. LLM 없이 graph를 만드는 LinearRAG가 LLM 기반 graph 방법과 bedrock에서 1.8점 이내로 비슷한 것도 LLM extraction의 이득이 작다는 것을 보여줘요.
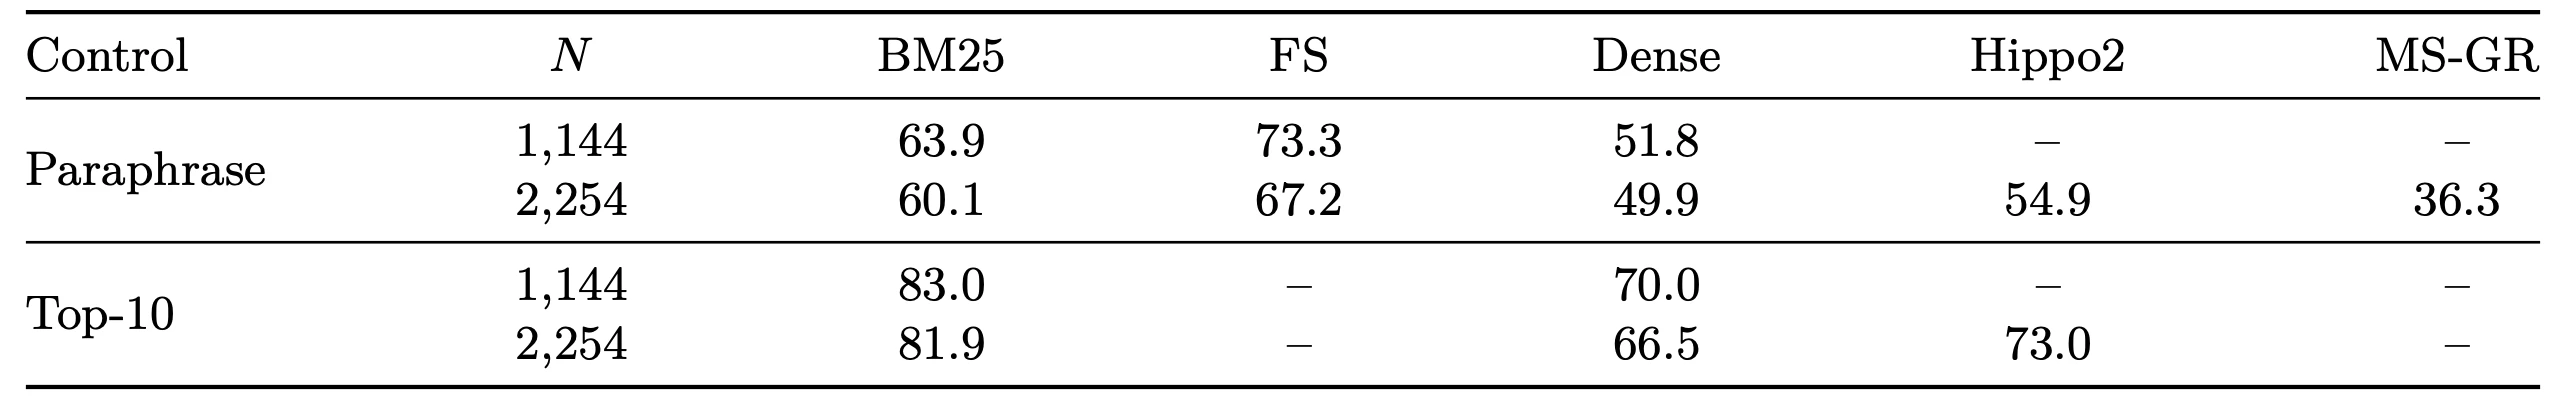
저자들은 이 우위가 실험 설정 때문인지도 확인해요.
- 질문을 paraphrase해서 lexical anchor를 약하게 만들면 BM25 점수가 떨어지고, bedrock에서는 File-System Agent(73.3)가 BM25(63.9)보다 높아요. 그래도 BM25는 dense와 graph보다 높아요.
- Retrieval depth를 top-5에서 top-10으로 늘려도 BM25가 dense와 HippoRAG보다 높아요.
- Trap 후보를 모을 때 BM25를 사용했기 때문에 benchmark가 BM25에 유리할 수 있어요. 저자들은 BM25를 거치지 않은 dense 검색으로도 trap과 lure가 다수 나온다는 점을 근거로 들지만, 기존 trap 대부분은 이 경로로 다시 찾지 못해서 편향 가능성이 완전히 배제되지는 않아요.
결과를 어떻게 해석할까
저자들의 실무 권고는 다음과 같아요.
- Enterprise 성격의 corpus에서는 BM25를 기본값으로 써요.
- 여러 문서를 모아야 하는 질문이 많다면 BM25로 후보를 찾고 agent가 좁혀진 후보를 탐색하는 Agent+BM25를 써요.
- LLM으로 만드는 graph index는 $10^5$–$10^6$개 문서 규모에서 정당화하기 어려워요. 구축 비용이 거의 선형이고 relation 중심 질문이 대부분인 경우에만 고려할 만해요.
- RAG 평가는 하나의 corpus 크기가 아니라 여러 scale에서의 정확도, 구축 및 query 비용, index coverage를 함께 보고해야 해요.
결과를 읽을 때는 몇 가지 조건을 함께 고려할 필요가 있어요.
- 실험은 하나의 synthetic enterprise corpus에서 진행됐어요. 정확한 식별자가 많은 질문과 “같은 주제지만 틀린 사실”로 정의된 trap은 exact matching에 유리한 설정이에요. 따라서 이 결과는 “BM25가 항상 이긴다”보다 “global ranking 단계가 없는 방법은 corpus가 커질 때 취약하다”에 가깝게 읽는 편이 정확해요.
- Dense retrieval은 0.6B embedding model 하나로만 측정했고, reranker나 hybrid retrieval은 포함되지 않았어요. DenseRAG의 낮은 점수에는 paradigm의 한계와 embedding model 크기의 영향이 섞여 있을 수 있어요.
- File-System Agent의 결과는 harness와 도구 설계에 민감해요.
grep은 최대 30개 경로,read_doc은 앞 8,000자만 반환하고, Codex harness로 바꾸면 bedrock 점수가 절반 가까이 떨어져요. 다만 예산 안에서 끝난 질문도 정확도가 떨어지고 Agent+BM25가 retrieval 도구만 바꿔 성능을 회복하므로, 후보 발견이 병목이라는 결론은 이런 설정 차이와 별개로 뒷받침돼요. - Reader와 policy model은 Qwen3.6-27B 하나예요. 더 강한 모델은 탐색을 더 효율적으로 할 수 있지만, 순차 탐색 비용이 corpus 크기에 따라 늘어나는 구조 자체는 바뀌지 않아요.