Contrastive Language Model: A System One Model for Fast and Generalizable Decision-Making
Contrastive Language Model: A System One Model for Fast and Generalizable Decision-Making, Blog, 2026
LLM agent는 매 step마다 다음 action을 token 단위로 생성해요. 추론 품질은 높지만, 게임 조작이나 tool routing처럼 짧은 간격으로 반복되는 결정에는 latency가 부담이 돼요. 이런 결정을 빠르게 처리하는 모델을 System One 모델이라고 불러요.
Contrastive Language Model(CLM)은 Stanford와 NVIDIA Research가 2026년 9월 공개한 System One 모델이에요. State와 action을 contrastive learning으로 같은 embedding 공간에 정렬하고, 후보 action 중 state와 가장 가까운 것을 고르는 방식이에요. 이 글은 CLM의 방법론을 중심으로 정리하고, 결과와 해석을 덧붙여요.
CLM은 state와 action을 따로 encode한다
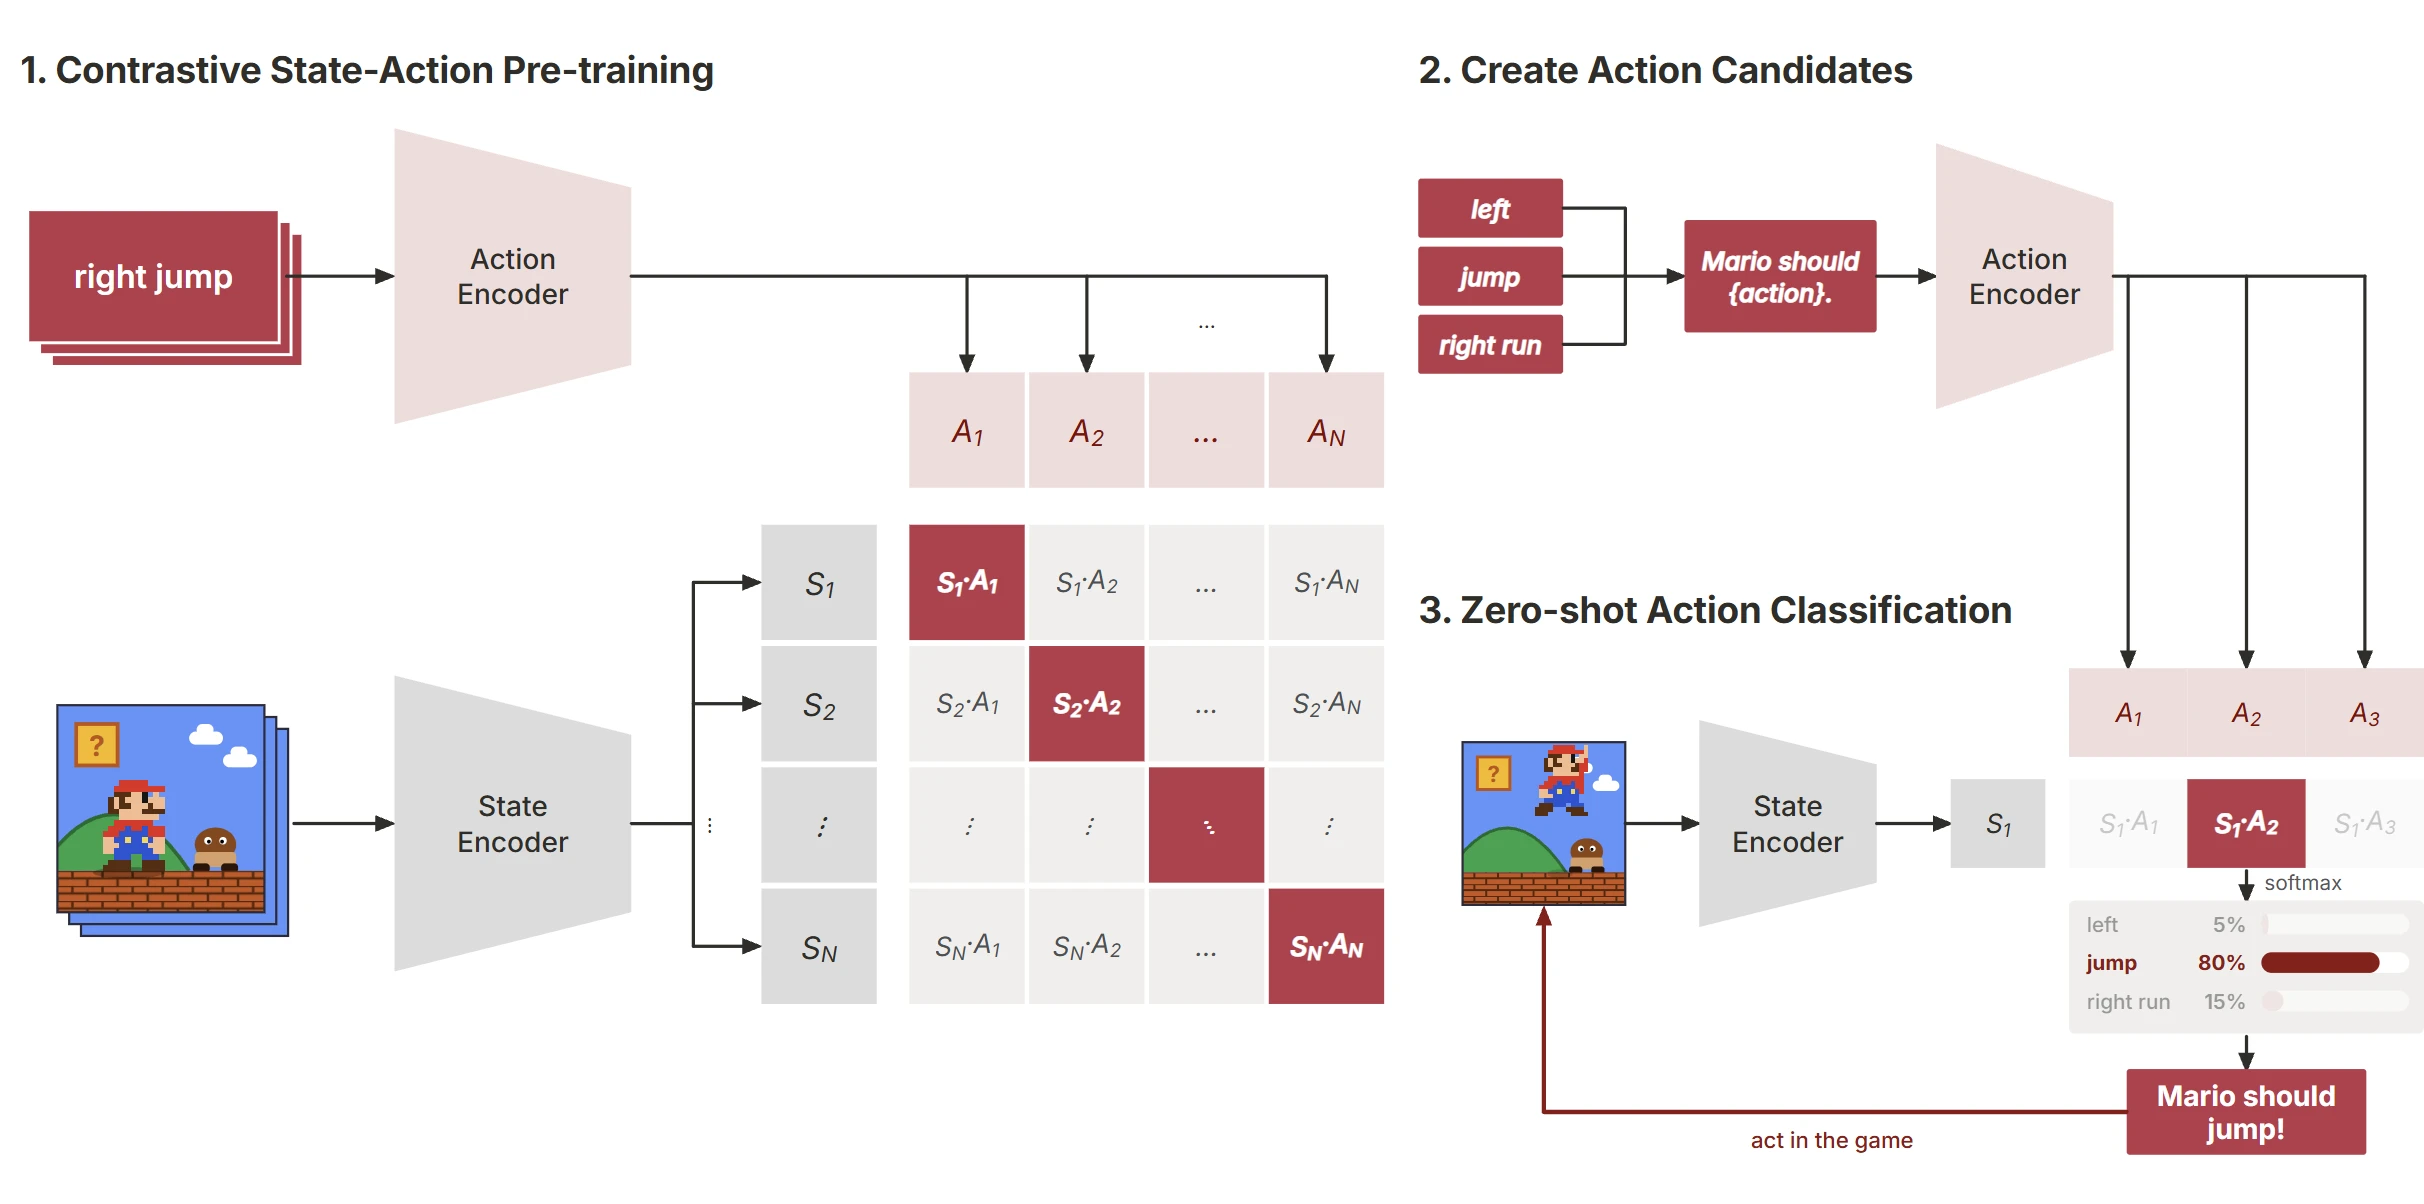
CLM의 구조는 CLIP 같은 dual encoder와 같아요. State와 action을 각각 독립적으로 embedding한 뒤, 두 벡터의 내적으로 점수를 매겨요.
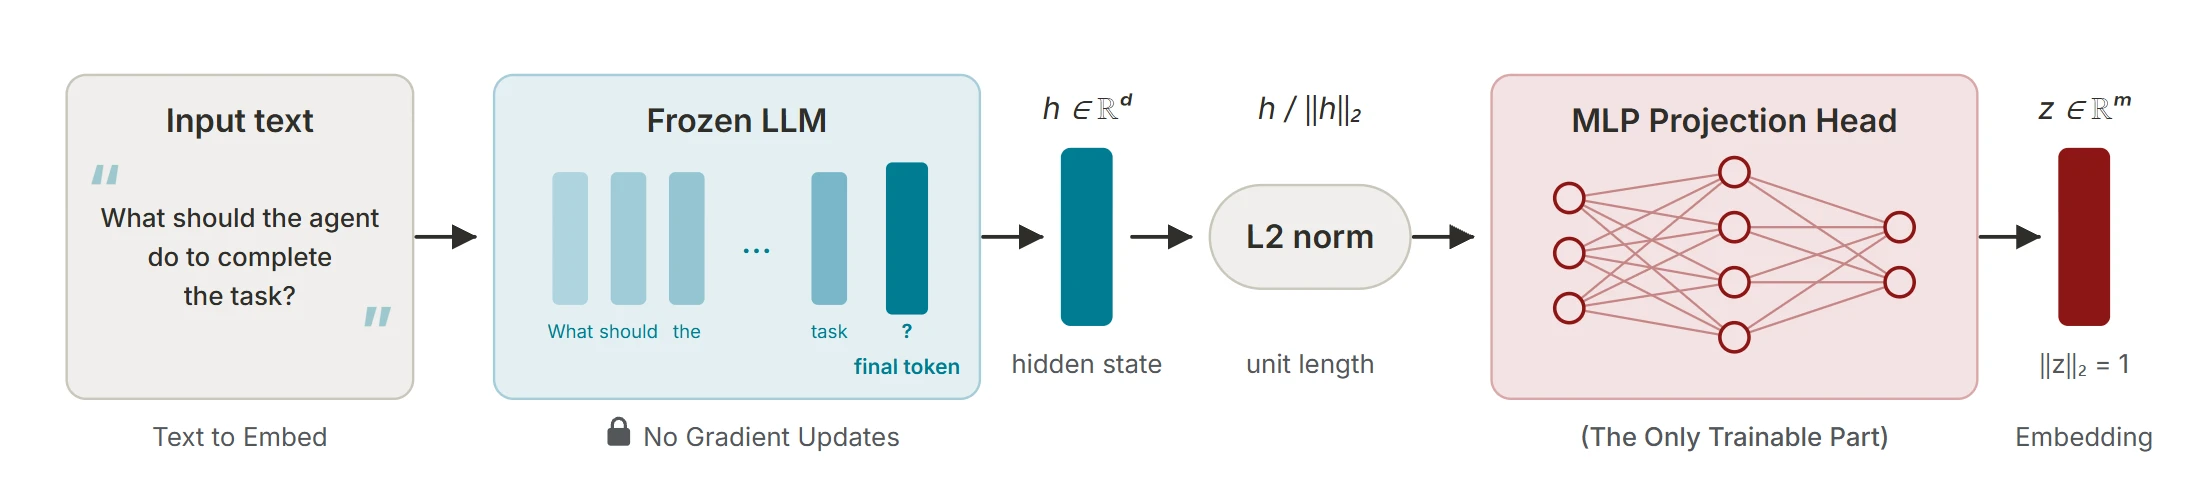
Backbone은 frozen Qwen3-8B이고, last-token pooling으로 문장 embedding을 얻어요. 그 위에 학습 가능한 state head $g_s$와 action head $g_a$를 올려요. 두 head는 약 20M parameter 규모의 projection network이고, backbone은 학습하지 않아요.
\[z_s = \frac{g_s(E(s))}{\lVert g_s(E(s)) \rVert}, \quad z_a = \frac{g_a(E(a))}{\lVert g_a(E(a)) \rVert}\] \[f(s, a) = \frac{z_s^\top z_a}{\tau}\]$E(\cdot)$는 Qwen3-8B의 pooled embedding이고, $\tau$는 학습되는 temperature예요. 점수는 cosine similarity를 $\tau$로 나눈 값이고, 후보 집합에 대해 softmax를 취하면 위의 $p(a_k \mid s)$가 돼요.
Backbone을 고정한 선택에는 두 가지 이점이 있어요.
- 학습 대상이 projection head뿐이라서 fine-tuning 비용이 낮아요. Backbone embedding을 미리 계산해 두면 학습 중에는 head의 forward와 backward만 돌리면 돼요.
- 공개된 reference head 파일은 75MB 정도라서, 같은 backbone 위에서 task별 head를 여러 개 두고 교체할 수 있어요.
분리된 encoding이 속도를 만든다
State와 action을 따로 encode하면 action embedding을 한 번 계산해 두고 재사용할 수 있어요. Agent loop에서는 state가 매 step 바뀌지만 가능한 action 집합은 대부분 고정되어 있어서 이 구조가 유리해요.
한 번의 결정에 드는 비용은 대략 다음과 같아요.
\[\text{Cost}_{\text{CLM}} \approx C_{\text{enc}}(s) + K \cdot d\]$C_{\text{enc}}(s)$는 state 하나를 8B encoder에 통과시키는 비용이고, $K \cdot d$는 cache된 $K$개 action과의 내적 비용이에요. 공개 구현에서 projection 차원 $d$는 512예요. State와 후보를 함께 읽는 방식은 후보 수나 후보 길이에 비례해 encoder 연산이 늘어나지만, CLM은 후보가 늘어도 내적만 늘어나요.
서빙 구현은 vLLM이 KV cache 공간을 미리 확보하듯, 시작할 때 GPU memory 일부를 vector cache로 잡아 두고 state와 action embedding을 LRU 방식으로 보관해요. RTX 4090에서 측정한 server-side p50 latency는 다음과 같아요.
| 3 actions | 50 actions | |
|---|---|---|
| 매 호출 새 state | 28.6 → 28.0 ms | 28.8 → 28.1 ms |
| 방문했던 state 재방문 (20개) | 1.7 → 0.6 ms | 2.0 → 0.7 ms |
화살표 왼쪽은 cache를 끈 경우, 오른쪽은 켠 경우예요. 새 state는 어차피 encoder를 거쳐야 하므로 차이가 거의 없어요. 이미 본 state가 반복되면 encoder 호출이 사라져서 약 2.8배 빨라져요. Action 수를 3개에서 50개로 늘려도 latency가 거의 변하지 않는 점도 확인할 수 있어요.
학습 목표는 bidirectional InfoNCE다
CLM은 state가 실제로 선택된 action과 가까워지고 나머지 action과 멀어지도록 학습해요. Batch 안의 $B$개 state-action 쌍으로 $B \times B$ similarity matrix를 만들고, 대각 원소를 positive, 나머지를 negative로 써요. CLIP과 같이 state에서 action으로, action에서 state로 두 방향의 retrieval을 함께 최적화해요.
\[\mathcal{L}_{\text{CLM}} = -\frac{1}{2B} \sum_{i=1}^{B} \left[ \log \frac{\exp\left(s_i^\top a_i / \tau\right)}{\sum_{j} \exp\left(s_i^\top a_j / \tau\right)} + \log \frac{\exp\left(a_i^\top s_i / \tau\right)}{\sum_{j} \exp\left(a_i^\top s_j / \tau\right)} \right]\]여기서 $s_i$, $a_i$는 정규화된 projection 결과인 $z_{s_i}$, $z_{a_i}$를 뜻해요.
In-batch negative는 대부분 state와 무관한 action이라서 구분이 쉬워요. 실제 결정에서는 그럴듯하지만 틀린 후보를 걸러내야 하므로, mid-training 단계에서는 state마다 hard negative $h_{ik}^{(a)}$를 추가해요.
\[\mathcal{L}_{s \rightarrow a}^{\text{hard}} = -\frac{1}{B} \sum_{i=1}^{B} \log \frac{\exp\left(s_i^\top a_i / \tau\right)}{\exp\left(s_i^\top a_i / \tau\right) + \sum_{k} \exp\left(s_i^\top h_{ik}^{(a)} / \tau\right)}\]분모에 의미상 가까운 오답이 들어가므로, 모델은 embedding 공간에서 정답과 근접 오답 사이의 margin을 벌리도록 학습돼요.
데이터는 세 단계로 어려워진다
CLM은 state-action 정렬 문제를 점점 어렵게 만드는 세 단계로 학습해요.
| 단계 | 데이터 | 규모 | 목적 |
|---|---|---|---|
| Pre-training | Nemotron DQA 질문-답변 쌍 | 약 60M | 넓은 의미 표현 학습 |
| Mid-training | Gemini 2.5 Flash-Lite로 만든 hard negative | 약 30M | 비슷한 후보 사이의 세밀한 구분 |
| Post-training | ADP agent trajectory, terminal trace | 약 1M | Agent의 context와 결정을 정렬 |
Pre-training에서는 질문을 state, 답변을 action으로 봐요. Mid-training의 hard negative는 Nemotron DQA 질문에 대해 의미는 비슷하지만 틀린 답을 생성한 것이에요. Post-training에서는 trajectory의 각 step을 하나의 state-action 쌍으로 쪼개요. Agent가 그 시점까지 본 context가 state이고, 실제로 내린 결정이 action이에요.
두 가지 설계 결정에 대한 ablation이 있어요.
- Post-training mixture의 40%를 Nemotron DQA replay로 채웠어요. Replay를 넣으면 hard negative top-1 accuracy가 69%에서 68.5%로 거의 유지되지만, agentic 데이터만으로 같은 step을 학습하면 56.2%까지 떨어져요. Agentic 데이터로 옮겨 가는 과정에서 생기는 forgetting을 replay가 막는다는 결과예요.
- 처음부터 hard negative로 학습하면 어떤지도 비교했어요. 정답 1개와 hard negative 10개로 구성한 약 100K개 held-out 질문에서, pre-training만 한 모델은 hard negative를 본 적 없이 52.1% top-1을 기록해요. 여기에 짧은 mid-training을 더하면 69.2%가 돼요. 처음부터 hard negative로 학습한 모델은 빠르게 오르지만 62.4%에서 정점을 찍고 overfitting돼요. 같은 compute에서 두 단계 방식이 7%p 높아서, hard negative는 pre-training을 대체하기보다 그 위에서 표현을 다듬을 때 효과가 있다고 볼 수 있어요.
Typed question은 후보 집합으로 바뀐다
CLM의 API는 Jev와 같은 세 가지 질문 타입을 받아요. 모든 타입은 “state + 후보 집합”으로 변환된 뒤 같은 scoring을 거쳐요.
-
Noul은 참·거짓 질문이에요. 참과 거짓 설명을 두 후보로 두고, 참일 확률 $p_{\text{true}}$를 반환해요. -
Choice는 선택지 분류예요. 각 선택지의 설명을 action으로 embedding하고, softmax 분포와 argmax를 반환해요. -
Score는 순서가 있는 rubric이에요. 각 level을 후보로 두고, 기댓값을 점수로 반환해요.
Choice와 Score는 confidence도 함께 반환해요. 가장 높은 확률에서 나머지 확률의 평균을 뺀 값이에요.
질문 문장(instructions)은 state 쪽에 붙고, 선택지 설명은 action 쪽에 들어가요. 선택지 설명은 요청이 바뀌어도 그대로라서 cache 대상이 돼요. Best-of-N 풀이나 tool 이름처럼 자유 형식 후보는 rank API로 같은 scoring을 그대로 적용해요.
Zero-shot 성능은 Jev와 비슷하고 더 빠르다

T-Rex(Chrome 공룡 게임), BFCL v4 tool calling, WikiRacing, Super Mario에서 CLM-8B와 Jev를 비교했어요. Task별 fine-tuning 없이 CLM-8B는 Jev와 비슷한 success rate를 보이고, latency는 최대 9배 낮아요 (demo).
속도 차이는 두 조건에서 커져요.
- WikiRacing처럼 후보 action 수가 많은 경우예요. Model card에 따르면 후보가 약 1,000개일 때 Jev보다 13배 빨라요.
- T-Rex처럼 같은 action이 여러 state에서 반복되는 경우예요. Action embedding을 한 번만 계산하면 되기 때문이에요.
두 조건 모두 앞에서 본 비용식 $C_{\text{enc}}(s) + K \cdot d$에서 예상되는 패턴이에요.
Verifier로 쓰려면 fine-tuning이 필요하다

Agentic coding benchmark에서는 CLM을 best-of-N verifier로 평가했어요. DeepSWE는 Opus 5, Terminal-Bench 2.1은 Fable 5로 task마다 여러 후보 풀이를 생성하고, CLM 또는 Jev가 그중 하나를 골라요. 평가는 학습 task와 겹치지 않는 held-out task에서 했고, DeepSWE는 38개, Terminal-Bench 2.1은 30개예요.
- Jev는 두 benchmark 모두에서 pass@1보다 낮은 점수를 기록해요. 무작위로 하나를 고르는 것보다 못하다는 뜻이라서, long-horizon 풀이를 판별하는 데는 맞지 않았다고 볼 수 있어요.
- CLM은 head만 가볍게 fine-tuning해서 DeepSWE 81.6%(31/38), Terminal-Bench 2.1 87.6%를 기록해요. 저자들은 이를 두 benchmark의 SOTA로 보고해요.
- Verifier latency는 H100 기준 Jev보다 4.1~5.7배 낮아요.
Fine-tuning은 backbone embedding을 미리 계산한 뒤 head만 학습하므로, task별 verifier를 만드는 비용이 낮아요. 공개 저장소는 DeepSWE head와 heldout task 목록을 함께 배포해서 결과를 재현할 수 있게 했어요.
결과를 어떻게 읽어야 할까
CLM의 기여는 agent의 결정을 retrieval 문제로 바꾸고, dual encoder 구조의 효율을 그대로 가져온 데 있어요. 몇 가지는 조건을 붙여 읽을 필요가 있어요.
- 재사용을 통해 속도를 높여요. 후보가 많거나 state와 action이 반복되는 환경에서 이득이 커요.
- State와 action 사이에 token 수준의 상호작용이 없어요. 두 embedding의 내적 하나로 판단하므로, 세밀한 차이는 embedding geometry에 담겨야 해요. Hard negative mid-training으로 52.1%에서 69.2%까지 올렸지만, 11개 중 하나를 고르는 문제에서 약 30%는 여전히 틀려요. Cross-attention 기반 reranker와의 정확도 차이는 이 자료에서 직접 비교되지 않았어요.
- 출력 확률은 주어진 후보 집합 안에서의 상대 점수예요. Model card도 이 점을 limitation으로 명시해요. Calibration을 따로 학습하지 않았으므로, 확률값 자체를 threshold로 쓰려면 별도 검증이 필요해요.
- Verifier SOTA는 task별 fine-tuning을 거친 head의 결과예요. 공개 checkpoint를 zero-shot으로 쓰면 이 수치가 나오지 않아요. 또한 held-out task가 38개, 30개라서 task 하나가 각각 약 2.6%p, 3.3%p에 해당해요. Task를 분리한 평가라는 점은 신뢰도를 높이지만, 수치 차이를 해석할 때 표본 크기를 함께 고려하는 편이 좋아요.
- Head는 Qwen3-8B의 last-token pooled embedding에 묶여 있어요. Backbone을 바꾸면 head를 다시 학습해야 해요.
- 이 결과는 peer review를 거친 논문이 아니라 blog와 코드로 공개된 내용이에요. 저자들은 multimodal CLM-35B를 후속으로 예고했고, scaling law가 가리키는 대로 encoder를 키웠을 때 정확도가 얼마나 오르는지가 다음 확인 지점이에요.