E-Commerce를 위한 상품 이미지 Retrieval
평소 추천 시스템을 다루며 e-commerce 데이터로 텍스트 검색을 연구해 왔어요. 그러다 이 도메인에서 이미지 데이터는 어떻게 탐색해야 할지 궁금해졌어요. 그래서 데이터 2종으로 image to image 검색과 text + image 멀티모달 검색의 성능을 비교해 보려 해요.
다양한 카테고리의 온라인 상품 이미지
온라인 상품 이미지 데이터로는 Stanford Online Products와 ILIAS를 사용해요.
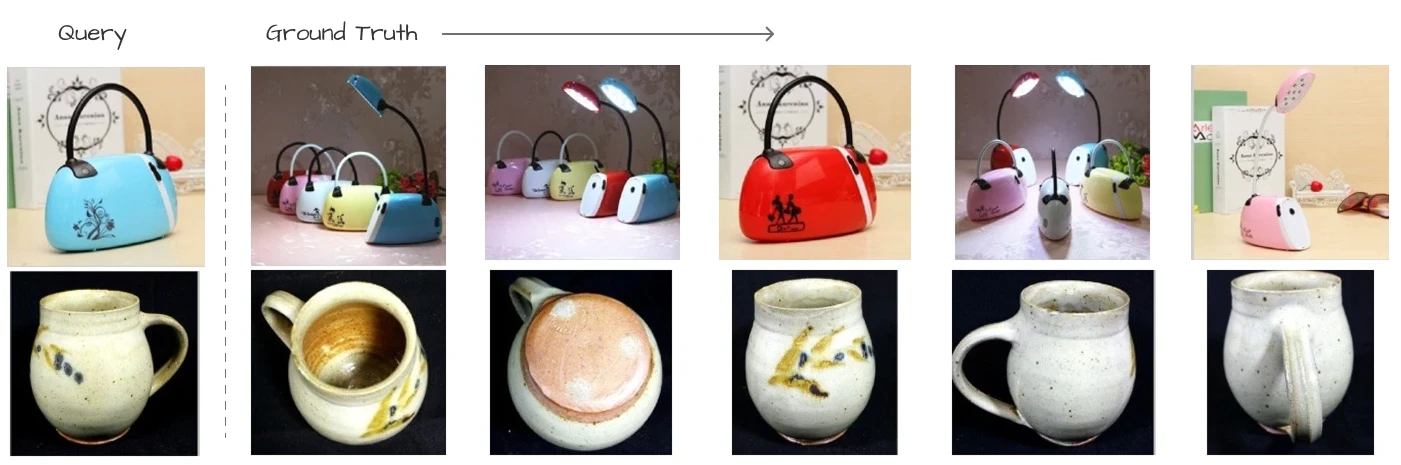 SOP 예시
SOP(Stanford Online Products)는 eBay에서 수집한 데이터로, 상품 22,634개에 대한 이미지 120,053장으로 구성돼요. 상품당 평균 이미지 수는 5.3장이에요. 같은 상품을 여러 각도에서 촬영한 이미지, 색상이 다른 이미지, 연출을 달리한 이미지가 함께 들어 있어요.
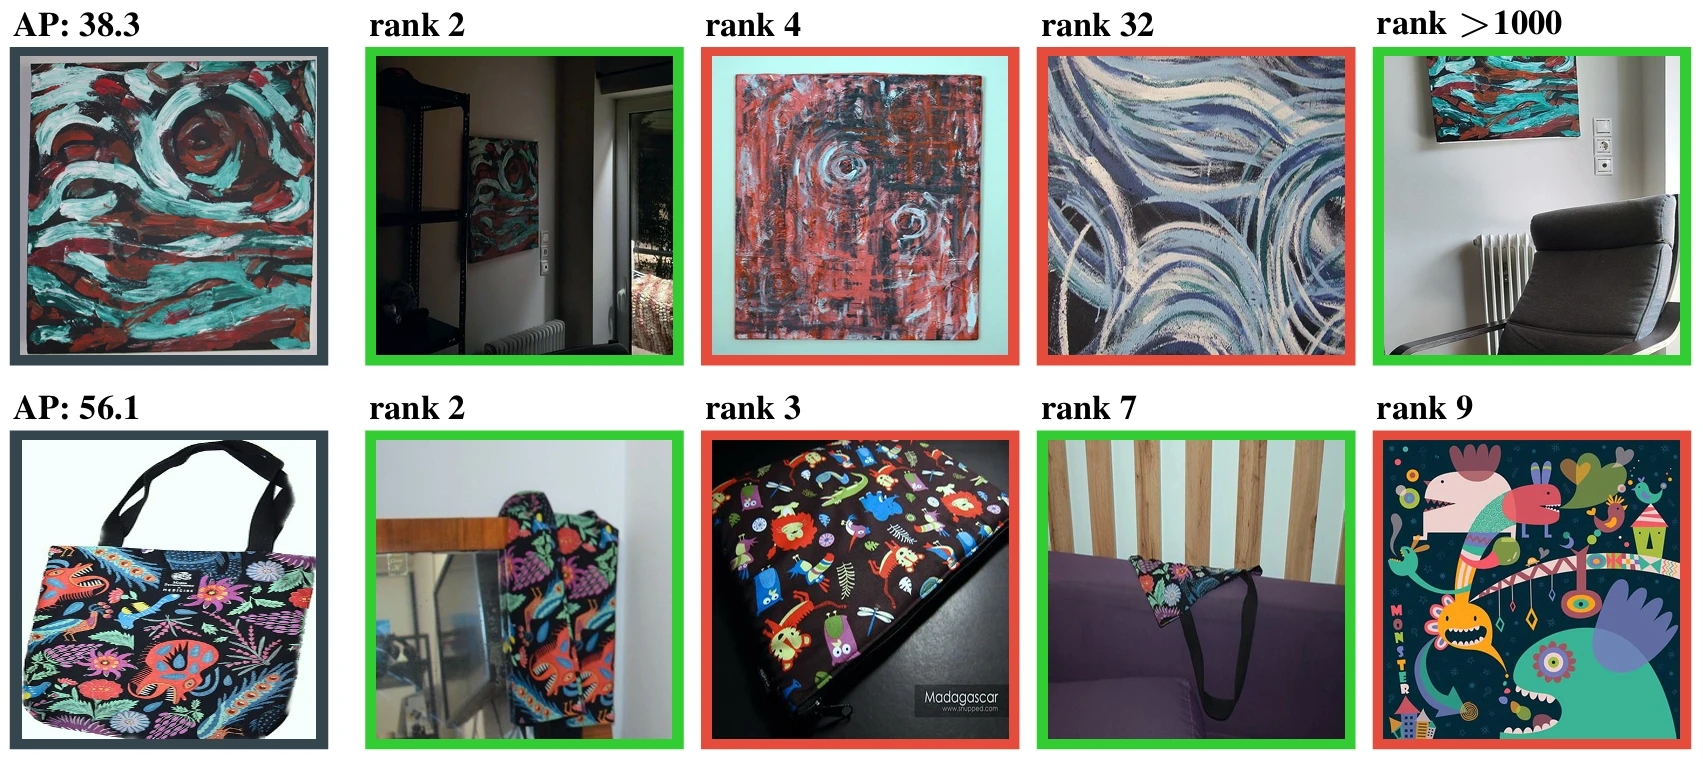 ILIAS, SigLIP Rank
ILIAS는 객체 1,000개에 대한 이미지 5,947장을 담고 있어요. 검색용 쿼리는 이미지 쿼리 1,232개와 텍스트 쿼리 1,000개이고, 이에 대한 positive 정답이 4,715개 매겨져 있어요. 텍스트 쿼리는 “The image shows …“와 같은 형태예요. CVPR 2025에서 소개된 비교적 최신 데이터예요.
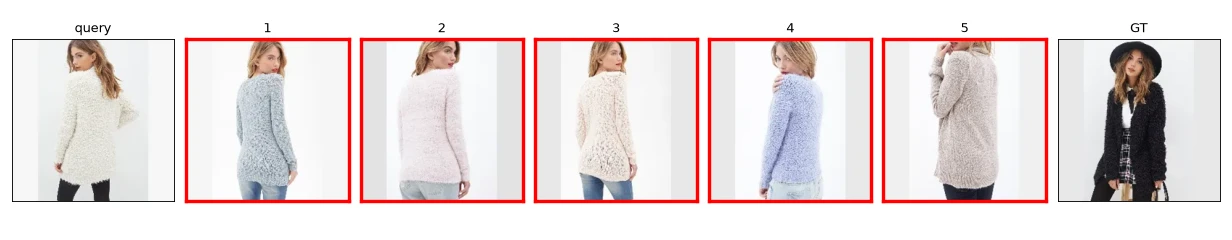 Inshop, DINO-v3 실패 사례
DeepFashion 데이터도 함께 분석했지만 이 글에서는 제외했어요. DeepFashion은 의류라는 한 카테고리만 다루기 때문에 모델이 더 정교한 특징을 찾아내야 해요. 그래서 평가용으로는 좋은 데이터예요. 하지만 failure case를 분석해 보니, 일부 ground truth는 사람이 눈으로 봐도 구분하기 힘든 경우가 종종 있었어요. 그래서 최종 평가에는 SOP와 ILIAS를 사용했어요.
Image Encoder 모델
모델은 클래식한 encoder 4개, e-commerce 도메인에 맞춰 학습된 encoder 2개, 공개된 지 5일 된 최신 임베딩 모델 1개를 사용했어요.
| Model | Param | Embedding dim | Input Image size |
|---|---|---|---|
| CLIP | 86M | 512 | 224×224 |
| SigLIP2 | 93M | 768 | 224×224 |
| DINO2 | 87M | 768 | 224×224 |
| DINO3 | 86M | 768 | 224×224 |
| Marqo-embedding-B | 93M | 768 | 224×224 |
| Marqo-embedding-L | 316M | 1024 | 256×256 |
| Embedding-Gemma2 | 438M | 768 | 가변 |
*위 표의 embedding dim은 image encoder 기준이에요.
CLIP은 전통적인 multi-modal encoder예요. Contrastive loss 기반 representation learning으로 서로 다른 모달리티를 같은 embedding 공간에 align하도록 학습됐어요. CLIP 학습이 성공한 이후, 많은 multi/omni-modal 학습에서 contrastive learning을 표준처럼 사용하고 있어요. 그래서 contrastive learning을 사용한 가장 기본 baseline으로 CLIP을 골랐어요.
SigLIP2은 Google이 공개한 multi-modal encoder로, 현재 가장 표준적으로 쓰이는 모델 중 하나예요. CLIP의 contrastive loss는 softmax를 사용해요. softmax를 쓰면 배치 안의 positive sample과 negative sample을 모두 본 뒤에야 loss를 계산할 수 있어요. 반면 sigmoid를 쓰면 각 샘플마다 positive / negative를 구분하는 binary classification 문제로 정의할 수 있어요. 이렇게 하면 샘플을 하나씩 독립적으로 판단하므로 batch에 따른 제약이 줄어들어요. 이 실험에서 사용한 SigLIP2는 self-distillation, masked prediction 등 정교한 학습 레시피를 더해 성능을 끌어올린 버전이에요.
DINO-v2 & DINO-v3는 Meta가 vision foundation model을 목표로 만든 모델이에요. ViT에 self-supervised learning과 여러 잡기술을 더해 성능을 극한까지 끌어올렸어요. 이미지만 입력으로 받지만, segmentation이 가능할 만큼 정교한 visual feature를 찾는 데 강해요. DINO는 학습 과정이 복잡해서 블로그(DINO)에서 따로 자세히 다뤘어요.
Marqo-embedding은 e-commerce 도메인에 맞게 학습한 모델이에요. 학습 레시피가 공개되지 않아 세부 정보는 알 수 없어요. 다만 자체 벤치마크 기준으로 SigLIP이나 상용 임베딩 모델보다 성능이 좋은 SOTA라고 주장해요. Embedding dim은 1024로 이 글의 비교군 중 가장 커요.
Embedding-Gemma2는 공개된 지 일주일도 안 된 신상 모델이에요. Gemma4를 기반으로 텍스트, 이미지, 비디오, 오디오를 하나의 임베딩 공간에 정렬했다고 해요. Context window는 8,192 tokens이고, 이미지 입력도 280 vision tokens까지 받아요. 이 값을 역으로 계산하면 약 803x803 정도의 이미지를 입력할 수 있어요. 그래서 224px 또는 256px을 받는 다른 모델과 달리 더 풍부한 정보를 담을 수 있어요.
평가지표
Query 하나마다 검색 대상을 유사도 순으로 정렬(rerank)해요. $i$번째 결과가 query와 같은 상품이면 $\mathrm{rel}_q(i)=1$, 아니면 $0$이에요. $P_q$는 gallery 안에 있는 query의 정답 집합이고, $|Q|$는 query 수예요. ILIAS에서는 query 이미지 1,232장으로 정답 이미지 4,715장 안에서 찾아요. SOP에서는 test split 60,502장이 모두 query가 되고, 자기 자신을 뺀 나머지에서 찾아요.
R@k (Recall@k)는 상위 $k$개 안에 정답이 하나라도 있는 query의 비율이에요.
\[\mathrm{R@}k = \frac{1}{|Q|} \sum_{q \in Q} \mathbb{1}\Big[\sum_{i=1}^{k} \mathrm{rel}_q(i) \ge 1\Big]\]mAP@K는 정답이 얼마나 위쪽에 모여 있는지까지 반영해요. 정답이 나온 순위마다 precision을 구해 더하고, 정답 수로 나눠 query별 AP를 만들어요. 그다음 모든 query의 AP를 평균 내요. ILIAS 공식 평가와 같은 정의이고, $K=1000$을 써요. 분모는 $\min(K, |P_q|)$로 두어, 정답이 $K$개보다 많아도 최댓값이 1이 되도록 해요.
\[\mathrm{Prec}_q(i) = \frac{1}{i}\sum_{j=1}^{i} \mathrm{rel}_q(j), \qquad\] \[\mathrm{AP@}K_q = \frac{1}{\min(K, |P_q|)} \sum_{i=1}^{K} \mathrm{Prec}_q(i)\,\mathrm{rel}_q(i), \qquad\] \[\mathrm{mAP@}K = \frac{1}{|Q|}\sum_{q \in Q} \mathrm{AP@}K_q\]R@1은 “1등이 정답인가”, R@100은 “100등 안에 정답이 있나”를 보기 때문에 정답 위치가 거칠게 반영돼요. mAP는 정답이 여러 개일 때 모두 위쪽에 있어야 높아지므로 더 엄격한 지표예요.
이미지로 같은 상품을 찾을 수 있을까
ILIAS
| Model | R@1 | R@10 | mAP@1000 | Latency (ms) | Peak VRAM (MB) | Batch |
|---|---|---|---|---|---|---|
| embeddinggemma2 | 0.881 | 0.963 | 0.647 | 97.8 | 3209 | 32 |
| dinov3_b | 0.737 | 0.886 | 0.474 | 8.3 | 746 | 128 |
| marqo_ecom_l | 0.733 | 0.894 | 0.461 | 8.1 | 2166 | 128 |
| siglip2_b16 | 0.709 | 0.884 | 0.448 | 5.2 | 1296 | 128 |
| marqo_ecom_b | 0.686 | 0.852 | 0.400 | 5.1 | 972 | 128 |
| dinov2_b | 0.578 | 0.769 | 0.336 | 5.9 | 871 | 128 |
| clip_b16 | 0.454 | 0.717 | 0.258 | 3.5 | 861 | 128 |
Embedding-Gemma2의 R@1이 0.881로 가장 높았어요. 2위인 DINO-v3와 비교해도 약 1.2배 높아요. Embedding-Gemma2는 파라미터가 438M로 가장 크고, 입력 가장 큰 이미지를 받아요. 그래서 체급 자체에서 오는 이득이 있다고 생각해요. Latency는 batch size나 GPU 운영 환경 등의 차이 때문에 공정하게 비교하기 어려워요. 그래도 다른 모델과 적게는 12배, 많게는 28배까지 차이가 나서 효율 면에서는 아쉬운 모습이었어요.
두 번째는 DINO-v3예요. E-commerce에 fine-tune된 marqo보다도 R@1과 mAP@1000이 높았어요. 다만 그 차이가 유의미하게 크지는 않았어요.
| 카테고리 (주요 하위 분류) | embeddinggemma2 | dinov3_b | marqo_ecom_l | siglip2_b16 |
|---|---|---|---|---|
| technology (automation, appliances, multimedia) | 0.763 | 0.661 | 0.637 | 0.568 |
| landmark (public art, architecture, sign) | 0.656 | 0.543 | 0.429 | 0.455 |
| art (sculpture, painting, paper model) | 0.643 | 0.499 | 0.469 | 0.470 |
| household (tableware, decor, container) | 0.605 | 0.463 | 0.497 | 0.425 |
| product (drink, food, hygiene) | 0.686 | 0.464 | 0.467 | 0.489 |
| toy (action figure, stuffed, trading) | 0.648 | 0.426 | 0.434 | 0.440 |
| fashion (accessory, outwear, jewelry) | 0.620 | 0.393 | 0.437 | 0.397 |
| media (book, sticker, stamp) | 0.659 | 0.322 | 0.381 | 0.387 |
카테고리별로 봐도 모든 영역에서 Embedding-Gemma2의 성적이 가장 좋았어요.
SOP
| Model | R@1 | R@10 | Latency (ms) | Peak VRAM (MB) | Batch |
|---|---|---|---|---|---|
| embeddinggemma2 | 0.749 | 0.888 | 97.8 | 3209 | 32 |
| siglip2_b16 | 0.744 | 0.888 | 5.1 | 1296 | 128 |
| marqo_ecom_l | 0.718 | 0.871 | 8.1 | 2166 | 128 |
| marqo_ecom_b | 0.693 | 0.852 | 3.5 | 972 | 128 |
| dinov3_b | 0.653 | 0.807 | 11.1 | 746 | 128 |
| clip_b16 | 0.593 | 0.762 | 3.9 | 861 | 128 |
| dinov2_b | 0.550 | 0.711 | 5.1 | 871 | 128 |
SOP에서도 Embedding-Gemma2의 성능이 가장 높았어요. ILIAS와 다른 점은 DINO-v3의 성능이 상대적으로 낮고, SigLIP2와 marqo가 각각 2, 3위를 기록했다는 점이에요. 다만 SOP의 성능을 해석할 때는 주의가 필요해요.
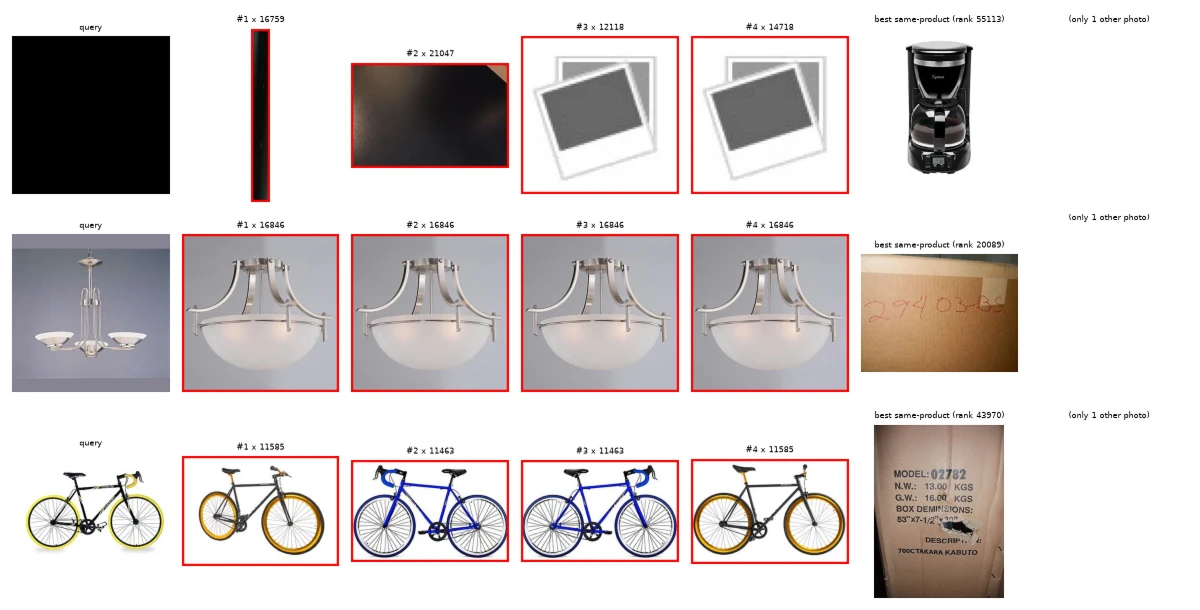
SOP에는 완전히 검은 이미지나 기본 이미지가 query나 GT로 들어간 경우가 있었어요. Test 60,502장 중 3장이 이런 경우예요. 또 1장은 해상도가 100px로 매우 낮아, 픽셀 수준에서 식별하기 어려웠어요. 이 밖에도 query는 상품인데 GT는 박스만 찍힌 경우 등 데이터 자체의 신뢰도가 낮았어요. eBay에서는 같은 상품 페이지에 등록된 이미지를 같은 상품으로 간주하기 때문에 생긴 문제로 보여요. 전체 점수에는 영향이 적겠지만, 실패 케이스 분석용으로는 적절하지 않다고 판단해 아래 챕터에서는 제외했어요.
상품이 작아서 찾기가 어려워요
문제 분석
ILIAS에서 Embedding-Gemma2, DINO-v3, SigLIP2의 실패 케이스를 분석해 봤어요. 아래 이미지는 각 모델의 오답 top-15 중 공통된 케이스를 정리한 거예요.
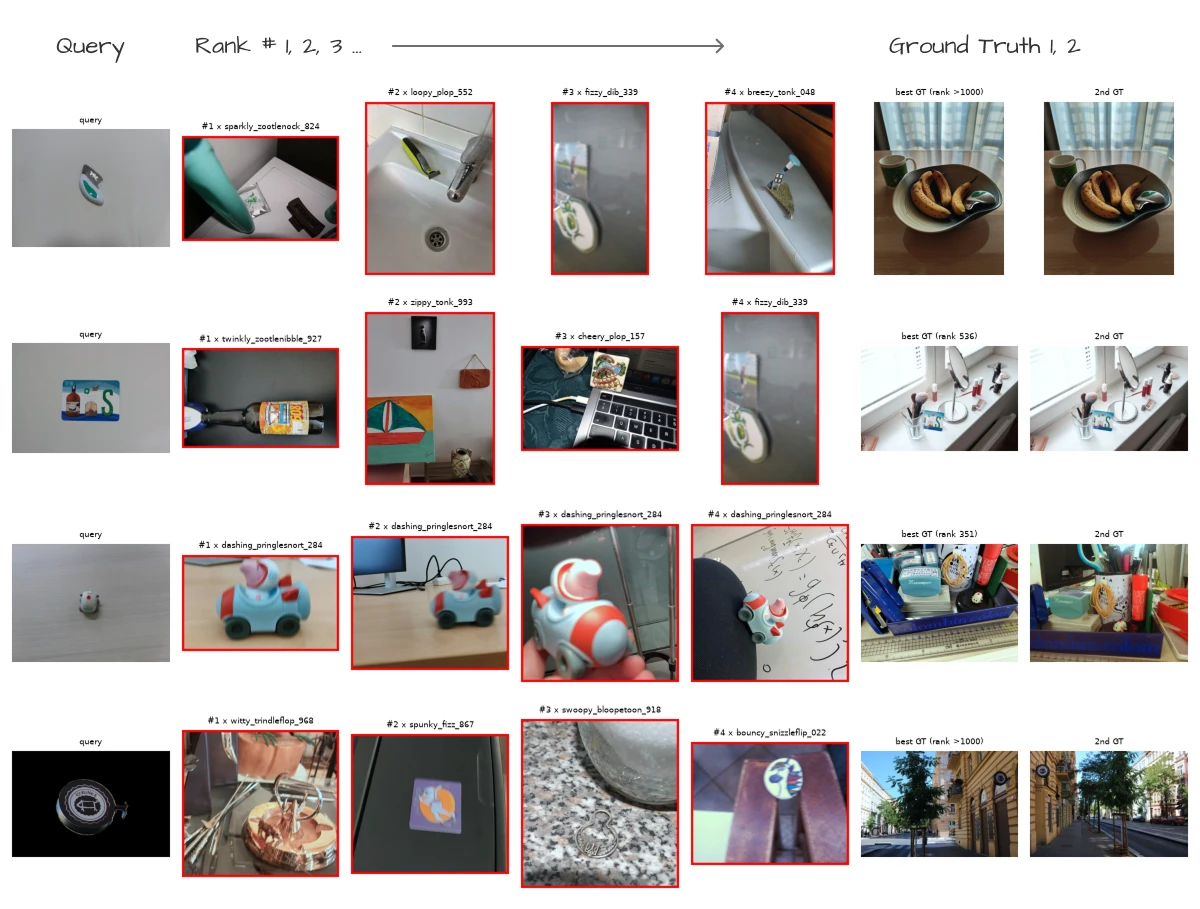 Embedding-Gemma2 실패 사례
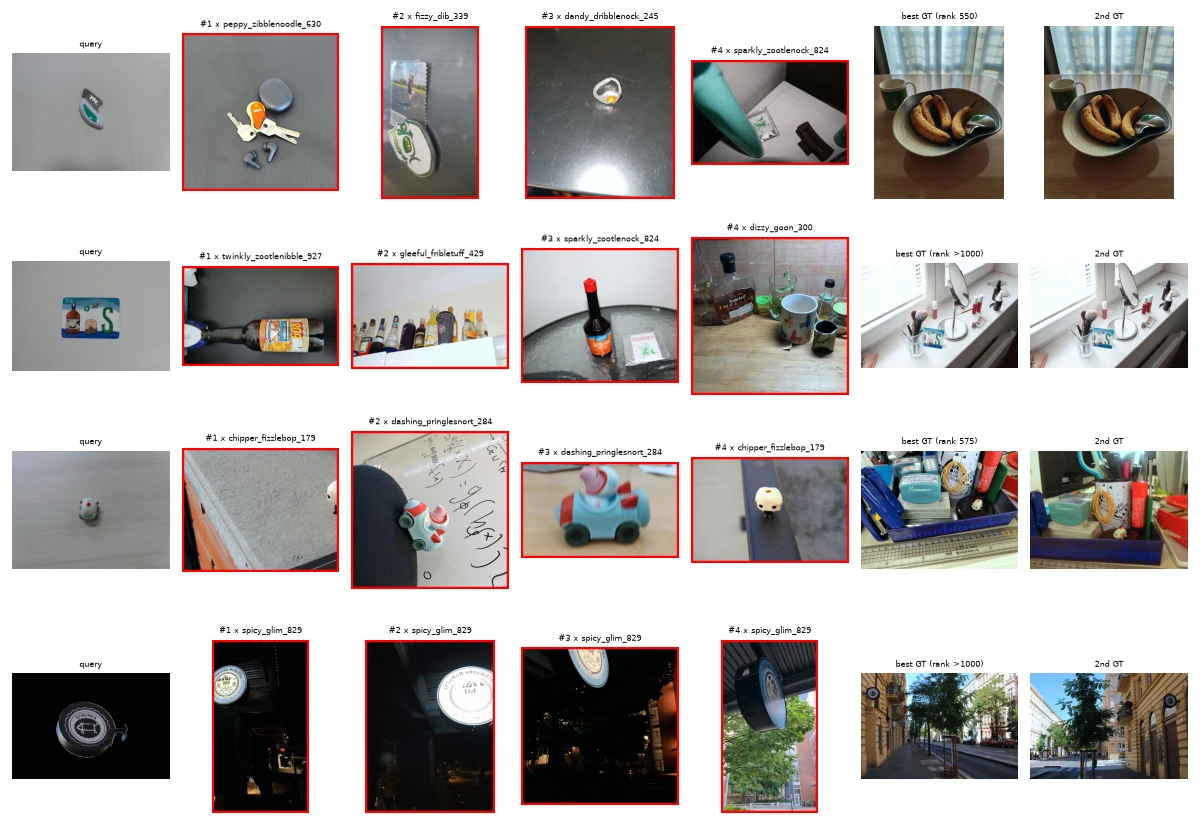 DINO-v3 실패 사례
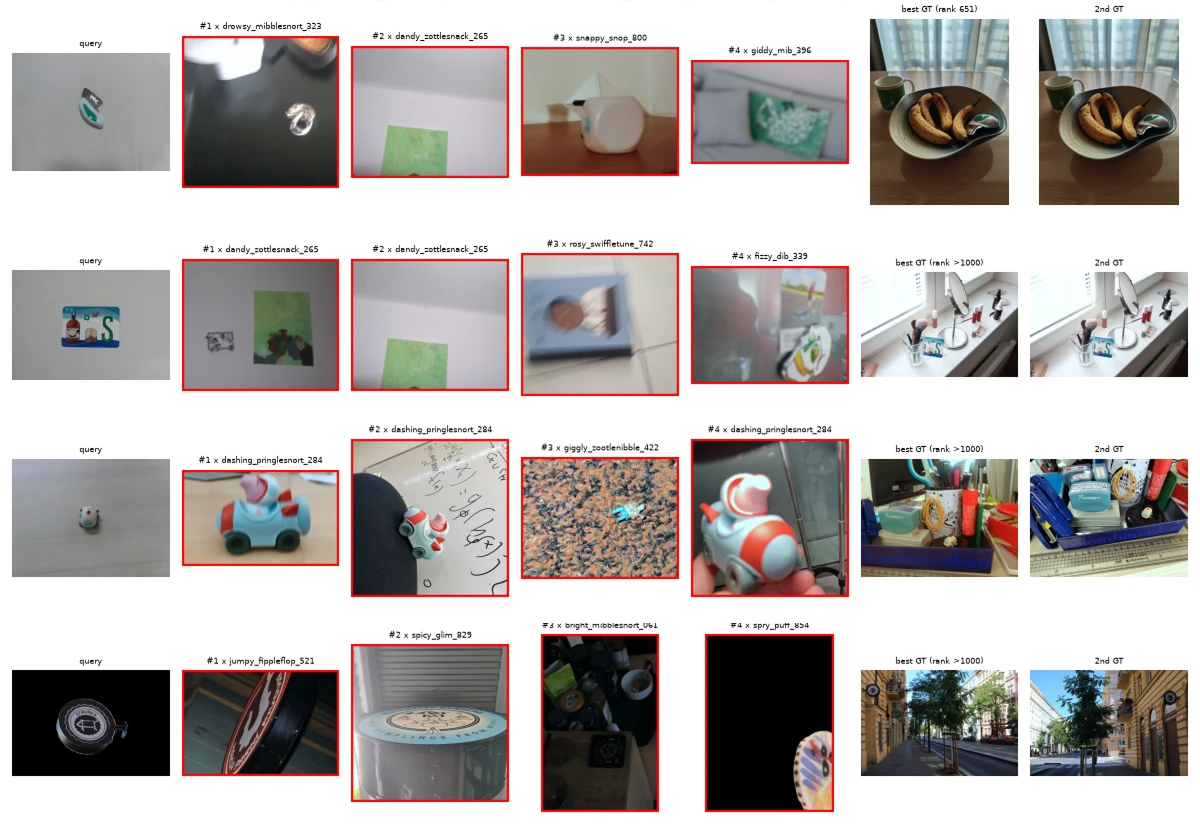 SigLIP2 실패 사례
모델별로 일관된 실패 패턴은 찾지 못했어요. Top-15만 보면 DINO-v3는 색상, 질감 같은 시각적 특징에 영향을 많이 받고, SigLIP2는 의미적으로 비슷한 오답을 찾는 패턴이 보였어요. 하지만 전체 실패 사례로 넓혀 보니 일반화하기 어려웠어요. 대신 실패 케이스 전반에 공통된 패턴이 하나 있었어요. GT 이미지에서 query object가 차지하는 영역이 매우 작으면 틀리는 경향이었어요. 그래서 GT 이미지를 주어진 bbox 영역으로 자른 뒤 rank를 매겨 봤어요.
| DINOv3 | SigLIP2 | EmbeddingGemma2 | |
|---|---|---|---|
| mAP@1000 | 0.474 → 0.726 | 0.448 → 0.820 | 0.647 → 0.926 |
| R@1 | 0.737 → 0.912 | 0.709 → 0.948 | 0.881 → 0.991 |
Embedding-Gemma2의 R@1은 0.991까지 올라갔고, DINO-v3도 0.737에서 0.912로 약 1.2배 올랐어요. 이로써 object detection이 image retrieval의 실패 지점으로 작용한다는 점을 확인했어요. 다만 ILIAS의 bbox는 사람이 직접 annotation한 것이라, 실제 production 환경에서 자동화할 수 있는지는 별개의 문제예요.
자동화 파이프라인 구축
정답 bbox 대신 object detection 모델로 뽑은 박스를 써 봤어요. open-vocabulary detector인 OWLv2로 GT 이미지마다 bbox 10개를 뽑아 crop하고, 각 crop을 인코딩해요.
\[s(q, d) = \max\Big(\text{sim}\big(f(q), f(d)\big),\ \max_{k=1,\dots,10} \text{sim}\big(f(q), f(c_k)\big)\Big)\]$f$는 이미지 인코더, $q$는 query 이미지, $d$는 GT 후보 이미지, $c_k$는 $d$에서 OWLv2로 뽑은 $k$번째 crop이에요. 이미지 하나의 점수는 query와, 전체 이미지의 유사도 또는 crop 10개 중 가장 높은 유사도 중 큰 값으로 정했어요. 이렇게 하면 전체 맥락은 그대로 보면서, 작은 물체가 배경에 묻힌 이미지는 물체 crop으로 구제할 수 있어요.
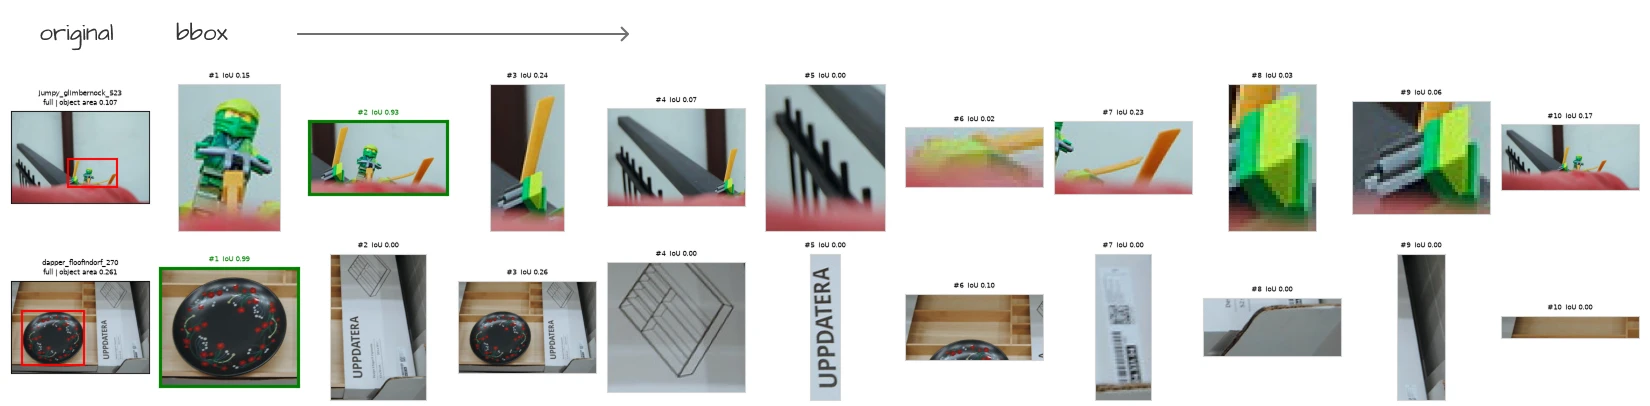
참고로 OWLv2의 detection 성능은 objectness 1위 박스 기준 평균 IoU 0.408 수준이에요. 10개 후보 중 IoU가 가장 높은 박스만 골라 계산하면 평균 0.824 수준이었어요.
| DINOv3 | SigLIP2 | EmbeddingGemma2 | |
|---|---|---|---|
| mAP@1000 | 0.474 → 0.731 | 0.448 → 0.771 | 0.647 → 0.892 |
| R@1 | 0.737 → 0.919 | 0.709 → 0.926 | 0.881 → 0.986 |
| R@100 | 0.971 → 0.997 | 0.970 → 0.995 | 0.989 → 0.999 |
Detection 성능이 그리 높지 않았는데도 retrieval 성능은 올라갔어요. Embedding-Gemma2 기준 mAP@1000은 약 1.4배 늘었고, R@100은 0.999로 GT 대부분이 100위 안에 들어왔어요. 다만 원본과 crop 10개를 모두 임베딩하므로, embed 연산이 약 11배, 저장된 DB의 인덱스 크기도 약 11배 늘어나요.
텍스트를 붙이면 성능이 더 좋아질까
제 경험상 다른 모달리티보다 텍스트를 함께 쓸 때 downstream task 성능이 올라가요. 언어 자체가 많은 정보를 압축적으로 담고 있기 때문인 것 같아요. 그래서 텍스트와 이미지를 모두 인코딩해 검색 쿼리로 써 봤어요. DINO 시리즈는 multi-modal이 아닌 image encoder라서 제외했어요.
| Model | R@1 [image→image] | R@1 [text→image] | R@1 [image+text] | mAP@1000 [image+text] |
|---|---|---|---|---|
| embeddinggemma2 | 0.881 | 0.821 | 0.881 | 0.667 |
| marqo_ecom_l | 0.733 | 0.623 | 0.778 | 0.507 |
| siglip2_b16 | 0.709 | 0.542 | 0.739 | 0.488 |
| marqo_ecom_b | 0.686 | 0.568 | 0.735 | 0.447 |
| clip_b16 | 0.454 | 0.439 | 0.550 | 0.329 |
Embedding-Gemma2는 image만 쓸 때와 image + text를 쓸 때의 R@1이 같아요. 참고로 image + text의 mAP@1000은 0.667로, 이미지만 쓸 때보다 2%p 올랐어요. Marqo는 멀티모달에서 R@1이 0.778로 4.5%p 올랐고, SigLIP도 R@1이 0.739로 3%p 올랐어요.
전반적으로 약간의 상승폭은 있지만, 텍스트를 함께 써서 얻는 이점은 크지 않아 보여요. 다만 텍스트는 단순 dense retrieval 외에도 키워드 매칭, reranking, agentic search 등 다양한 전략에 활용할 수 있어요. 그래서 풀고자 하는 도메인에 맞는 최적의 전략을 찾는 것도 재미라고 생각해요.