Elasticsearch를 활용한 논문 검색 맛보기
Elasticsearch를 도입한 이유
저는 요즘 주로 Information Retrieval을 다뤄요. BM25나 Vector Search 등을 구현할 때마다 인터페이스가 제각각이라, 직접 wrapper를 만들어 인터페이스를 통일해 왔어요. 그러다 보니 처음부터 공통된 인터페이스로 코드를 다루고 싶어졌어요. 예전에 Elasticsearch에 대해 들은 기억이 있어서 한번 시도해 보기로 했어요.
Elasticsearch에서는 이미 구현된 BM25를 바로 쓸 수 있어요. Vector search에는 HNSW(Hierarchical Navigable Small World) 기반 ANN(Approximate Nearest Neighbor)을 쓸 수 있고요. 분산 클러스터와 모니터링 기능도 함께 제공된다고 해요. 덕분에 low-level 구현을 신경 쓰지 않고 인터페이스만 활용하면 돼요.
이 글에서는 transformers 등의 패키지를 활용하려고 python을 선택했고, 기본 elasticsearch 패키지를 사용했어요. 조금 더 pythonic하게 코드를 쓸 수 있는 DSL(Domain Specific Language) 모듈(elasticsearch.dsl)도 있어요. 하지만 다른 언어로의 migration을 고려하고 학습도 할 겸 기본 인터페이스를 사용했어요.
Docker로 elasticsearch 띄우기
Elasticsearch는 코드 안에서 초기화하는 방식이 아니라, 서버로 띄운 뒤 python client에서 호출하는 방식으로 사용해요. 별도로 설치할 필요 없이 docker 컨테이너로 띄워서 쓸 수 있어요.
services:
  elasticsearch:
    image: docker.elastic.co/elasticsearch/elasticsearch:9.2.0
    container_name: elasticsearch
    environment:
      - discovery.type=single-node
      - xpack.security.enabled=false
      - ES_JAVA_OPTS=-Xms1g -Xmx1g
    ports:
      - "9200:9200"
    volumes:
      - es_data:/usr/share/elasticsearch/data
    restart: unless-stopped

volumes:
  es_data:
최신 python client를 쓰려면 9.x 버전이 필요해요. 중요한 부분은 아니지만, 로컬에서 간단히 실행하려고 security를 끄고 JVM에도 제한을 걸어 뒀어요 (environment 옵션 참고).
BM25와 출력 스키마
# client
es = Elasticsearch(ES_URL, request_timeout=30)

# BM25
resp = es.search(
    index=INDEX_NAME,
    size=k, # 검색할 문서 개수
    query={
        "multi_match": {
            "query": query,  # 검색할 쿼리
            "fields": ["title^2", "text"]
        }
    }
)
multi_match를 쓰면 내부적으로 BM25로 키워드를 검색해요. BM25는 키워드가 등장하는 문서를 모두 찾은 뒤, 등장 빈도와 문서 길이를 바탕으로 가중치를 매기는 검색 알고리즘이에요. 현대 검색 알고리즘에서 키워드 매칭 검색이라고 하면 보통 BM25를 가리켜요.
눈여겨볼 부분은 fields예요. 어떤 필드에 얼마만큼 가중치를 줄지 정하는 파라미터예요. 이해를 돕기 위해 출력 스키마부터 볼게요.
{
    "took": 5,
    "timed_out": false,
    "_shards": {...},
    "hits": {
        "total": {...},
        "max_score": 3.42,
        "hits": [
            {
                "_index": "documents",
                "_id": "1",
                "_score": 3.42,
                "_source": {
                    "title": "Information Retrieval",
                    "text": "An introduction to search engines."
                }
            },
            {
                "_index": "documents",
                "_id": "2",
                "_score": 2.15,
                "_source": {
                    "title": "Search Systems",
                    "text": "Information retrieval techniques."
                }
            }
        ]
    }
}
검색 결과는 hits.hits 안에 담겨요. 문서는 키워드와의 매칭 점수인 _score 기준으로 내림차순 정렬되고, 각 문서의 title과 text가 함께 포함돼요. 앞서 본 fields의 title^2는 title에 2배 가중치를 준다는 뜻이에요. 식으로 나타내면 아래와 같아요.
먼저 Document $D$와 Query $Q$에 대해 필드별 BM25 점수를 계산하고, title 점수에 2배 가중치를 줘요. 그다음 multi_match의 기본 타입(best_fields)에서는 그중 가장 높은 점수를 문서 점수로 사용해요. (tie_breaker 옵션을 주면 다른 필드 점수도 반영돼요.) 이 가중치는 어디까지나 예시이고, 문서 특성에 맞게 조절할 수 있어요.
Dense Retrieval
Vector search에 쓸 임베딩은 외부에서 직접 생성해야 해요. 코드의 세부 내용은 생략할게요.
es = Elasticsearch(ES_URL, request_timeout=30)
# bge 모델은 쿼리 앞에만 instruction prefix를 붙여요 (문서에는 붙이지 않아요)
QUERY_PREFIX = "Represent this sentence for searching relevant passages: "
query_vec = model.encode(QUERY_PREFIX + query, normalize_embeddings=True)

resp = es.search(
    index=INDEX_NAME,
    size=k,
    knn={
        "field": "embedding",
        "query_vector": query_vec.tolist(),
        "k": k,
        "num_candidates": max(NUM_CANDIDATES, k),
    },
    source_excludes=["embedding"],
)
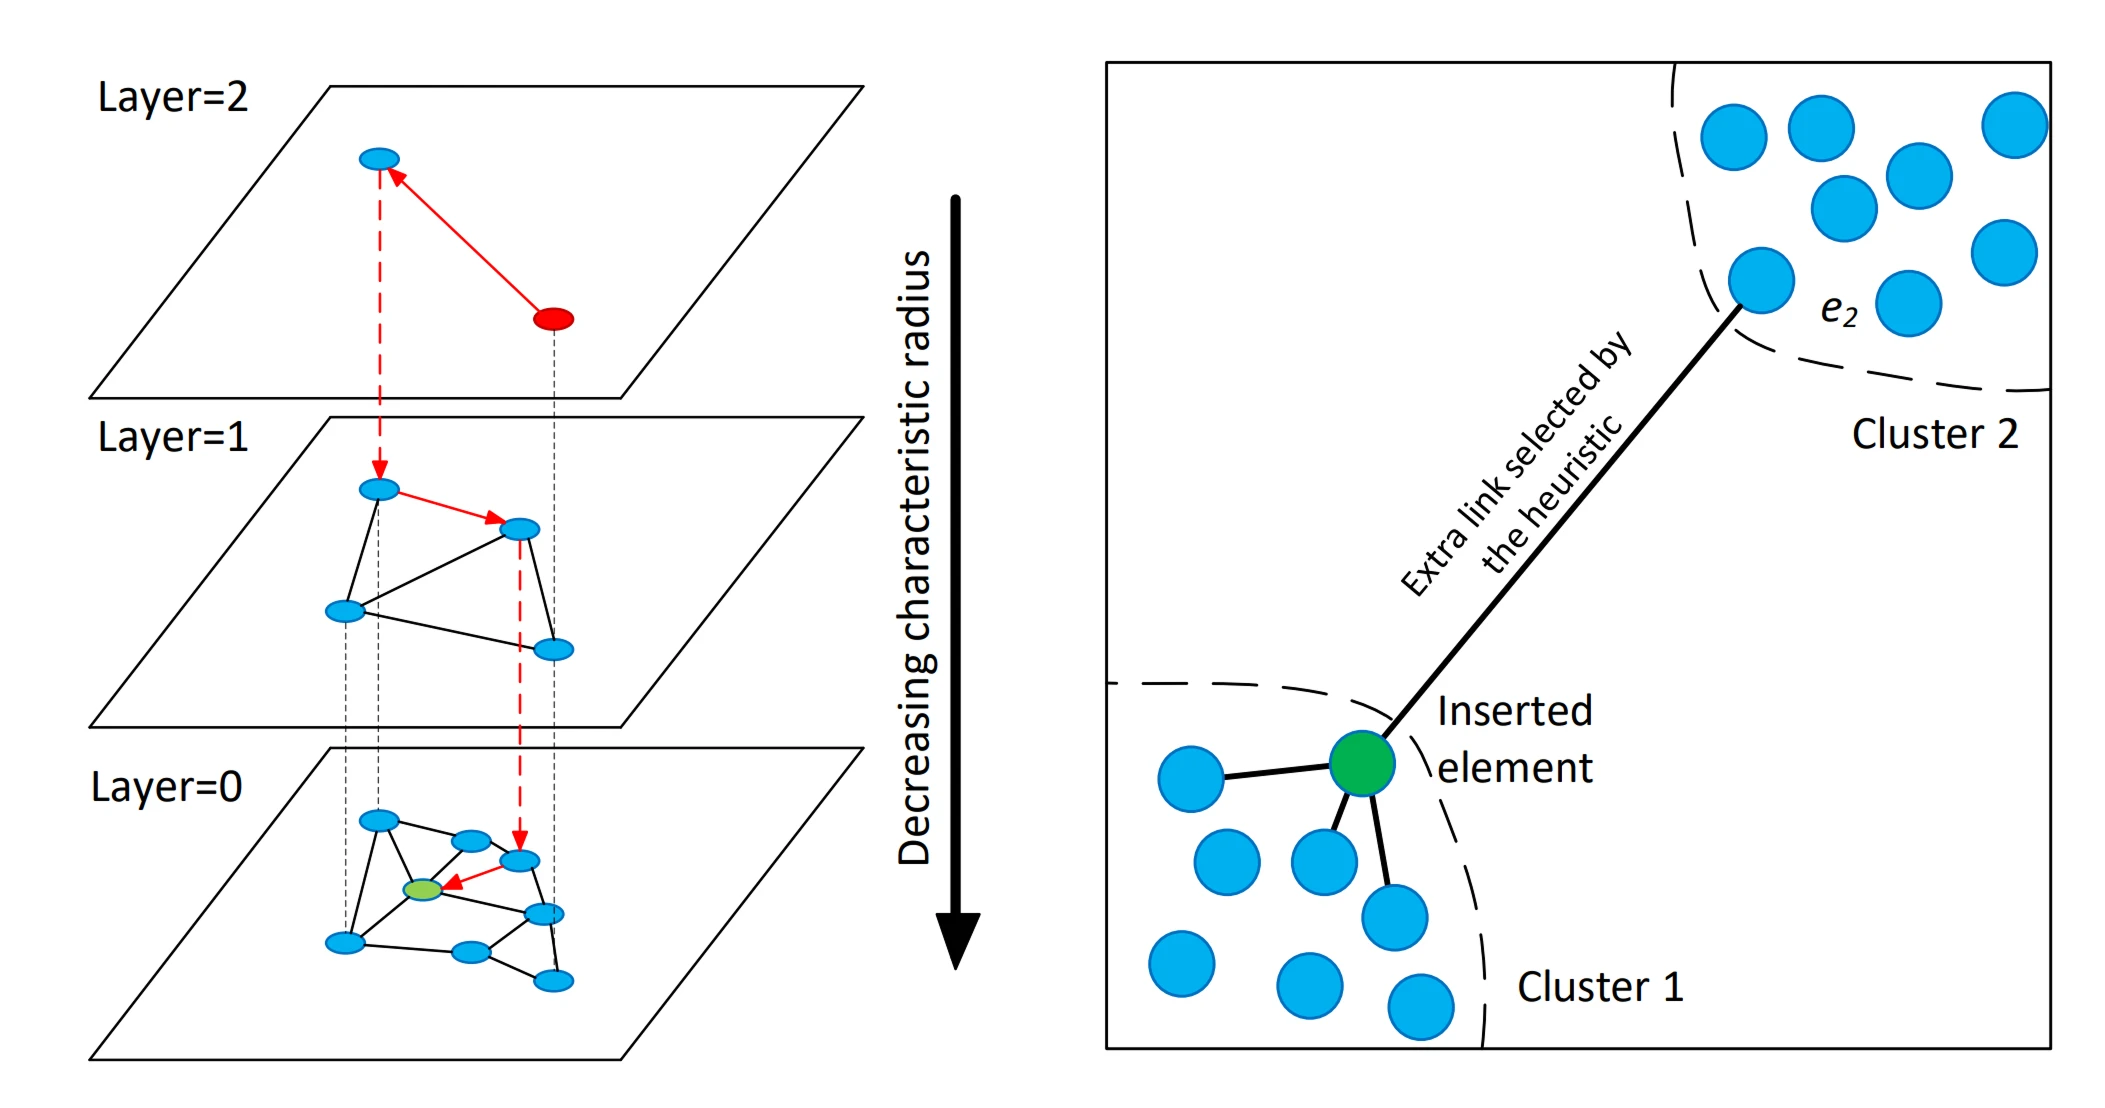
knn에 field: embedding을 지정하면 vector 기반으로 탐색해요. 탐색 알고리즘이나 similarity 측정 방식 등은 build하기 전에 커스텀할 수 있어요. 이 부분은 아래에서 따로 다룰게요.
 Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs
k와 num_candidates를 따로 두는 이유는 HNSW가 ANN 기반 탐색이기 때문이에요. 모든 vector를 하나씩 비교해 점수를 매기면 $O(N)$이 걸려 너무 느려요. 그래서 DB 내부에서는 vector를 계층 구조의 그래프로 인덱싱해요. 이때 탐색 범위에 따라 검색 결과의 재현율과 속도가 달라질 수 있어요. 그래서 num_candidates로 각 샤드(인덱스를 나눠 저장하는 단위)에서 고려할 후보 규모를 조절하고, 샤드별 후보를 취합해 최종 k개 결과를 반환해요. num_candidates를 높이면 보통 재현율은 올라가지만 검색 비용도 늘어나요.
마지막으로 source_excludes는 출력 스키마에서 임베딩 벡터 원본을 빼는 옵션이에요. 제가 쓴 9.2.0에서는 지정하지 않아도 _source에서 벡터가 빠져 있었지만, 명시적으로 ['embedding']을 제외해 뒀어요.
데이터 인덱싱
지금까지 검색 방법을 살펴봤으니, 이제 데이터를 빌드하는 방법을 볼게요.
INDEX_BODY = {
    "settings": {
        "number_of_shards": 1,
        "number_of_replicas": 0,
    },
    "mappings": {
        "properties": {
            "doc_id": {"type": "keyword"},
            "title": {"type": "text", "analyzer": "english"},
            "text": {"type": "text", "analyzer": "english"},
            "embedding": {
                "type": "dense_vector",
                "dims": EMBED_DIMS,
                "index": True,  # True여야 HNSW 그래프가 생성
                "similarity": "cosine",
                "index_options": {"type": "hnsw"}, # int4_hnsw, bbq_hnsw, flat...
            },
        }
    },
}

# 인덱스 생성
es = Elasticsearch(ES_URL)
es.indices.create(index=INDEX_NAME, **INDEX_BODY)
Shard 설정과 title, text, embedding의 세부 옵션을 JSON 형식으로 명세해요. title과 text에 analyzer를 지정하면 불용어 제거 같은 키워드 매칭용 전처리가 자동으로 적용돼요. 앞서 말했듯 similarity로 점수 계산 방식을, index_options로 인덱스 탐색 방법을 지정할 수 있어요. hnsw는 float 원본 정밀도를 사용하고, int4_나 bbq_ 계열은 양자화를, flat은 brute-force 비교를 사용해요.
es = Elasticsearch(ES_URL)
embeddings = model.encode(texts, normalize_embeddings=True)  # texts: "title. text"

# 인덱스에 삽입
actions = (
    {
        "_index": INDEX_NAME,
        "_id": d["id"],
        "_source": {
            "doc_id": d["id"],
            "title": d["title"],
            "text": d["text"],
            "embedding": emb.tolist(),
        },
    }
    for d, emb in zip(docs, embeddings)
)
helpers.bulk(es, actions, chunk_size=BULK_CHUNK_SIZE)

# 검색에 즉시 반영
es.indices.refresh(index=INDEX_NAME)
스키마에 맞게 actions를 정의하고, bulk로 실제 DB에 저장해요.
간단한 실험
실제로 잘 작동하는지 확인하려고 간단한 실험을 해 봤어요. 데이터와 모델은 다음과 같아요.
- Dataset: SciFact
- Embedding:
BAAI/bge-small-en-v1.5 - Reranker:
cross-encoder/ms-marco-MiniLM-L6-v2
SciFact는 검색 쿼리의 근거가 되는 논문 초록을 찾는 과제예요. 문서 5,183개와 쿼리 1,109개로 구성되고, test split 300개 쿼리와 정답 레이블이 포함되어 있어요. 임베딩 모델과 reranker는 로컬 환경의 RTX 4060 한 장에서 돌릴 수 있도록 가벼운 모델로 골랐어요. 사실 성능보다는 전체 프로세스를 돌려 보는 게 목적이었으니까요.
BM25와 Dense search로 각각 100개씩 뽑아 평가했어요. Hybrid 방식은 두 방식의 결과를 합친 뒤 reranker로 최종 순위를 매겨요. Reranker가 작아서 성능이 떨어질 수 있다는 우려가 있어, N=100개씩 뽑은 버전과 N=5개씩 뽑은 버전 두 가지로 평가해 봤어요.
| 지표 | BM25 | Dense | Hybrid(N=5) | Hybrid(N=100) |
|---|---|---|---|---|
| nDCG@1 | 0.4700 | 0.5900 | 0.5833 | 0.5700 |
| nDCG@3 | 0.5662 | 0.6582 | 0.6691 | 0.6403 |
| nDCG@5 | 0.5893 | 0.6823 | 0.6904 | 0.6623 |
| nDCG@10 | 0.6100 | 0.7057 | 0.7059 | 0.6815 |
| Recall@3 | 0.6326 | 0.7017 | 0.7279 | 0.6899 |
| Recall@5 | 0.6887 | 0.7640 | 0.7823 | 0.7418 |
| Recall@10 | 0.7502 | 0.8296 | 0.8251 | 0.7972 |
| Hit rate@5 | 0.7133 | 0.7833 | 0.8033 | 0.7633 |
| Hit rate@10 | 0.7733 | 0.8400 | 0.8433 | 0.8133 |
| MRR@10 | 0.5718 | 0.6725 | 0.6761 | 0.6521 |
Hybrid(N=5)는 Dense와 비슷하거나 일부 지표에서 약간 높았어요. 우려한 대로 후보를 많이 넣으면(N=100) 성능이 내려가, 표의 모든 지표에서 Dense보다 낮았어요. 원인은 검증하지 않았지만, reranker가 작거나 학습 도메인(MS MARCO)이 SciFact와 달라서일 수 있어요. 이 데이터에서는 dense retrieval이 BM25보다 더 정확했어요. 평균 latency(N=100)는 BM25가 47.1ms, dense retrieval이 57.8ms였어요. Hybrid는 reranker 단계에만 427.7ms(검색 포함 532.6ms)가 걸렸어요. 즉 BM25가 가장 빠르고, reranker 단계는 BM25보다 9배 정도 느려요. 참고로 BM25와 dense retrieval의 결과 일치도는 top-5에서 34%, top-100에서 28%로, 두 방식의 검색 양상이 서로 달랐어요.