Graph-based Memory에 jev를 활용한 Jev-Mem
Jev-Mem: System-One-Controlled Agentic Memory for Efficient AI Agents, arXiv, 2026.
MAGMA: A Multi-Graph based Agentic Memory Architecture for AI Agents, ACL’26 (arXiv).
Jev가 공개된지 일주일도 안 돼서 memory 논문이 나왔어요. Jev-Mem은 UT Dallas 연구팀이 제안한 agentic memory 구조예요. 같은 팀의 이전 연구인 MAGMA(Multi-Graph based Agentic Memory Architecture)에 이어서, memory를 관리하는 결정을 auto-regressive LLM 대신 가벼운 structured predictor에 맡겨요. LoCoMo에서 가장 강한 baseline보다 LLM-as-a-Judge 점수가 11.0% 높고, memory 구축 시간은 6.6배 짧아요.
Memory 제어가 병목이 된다
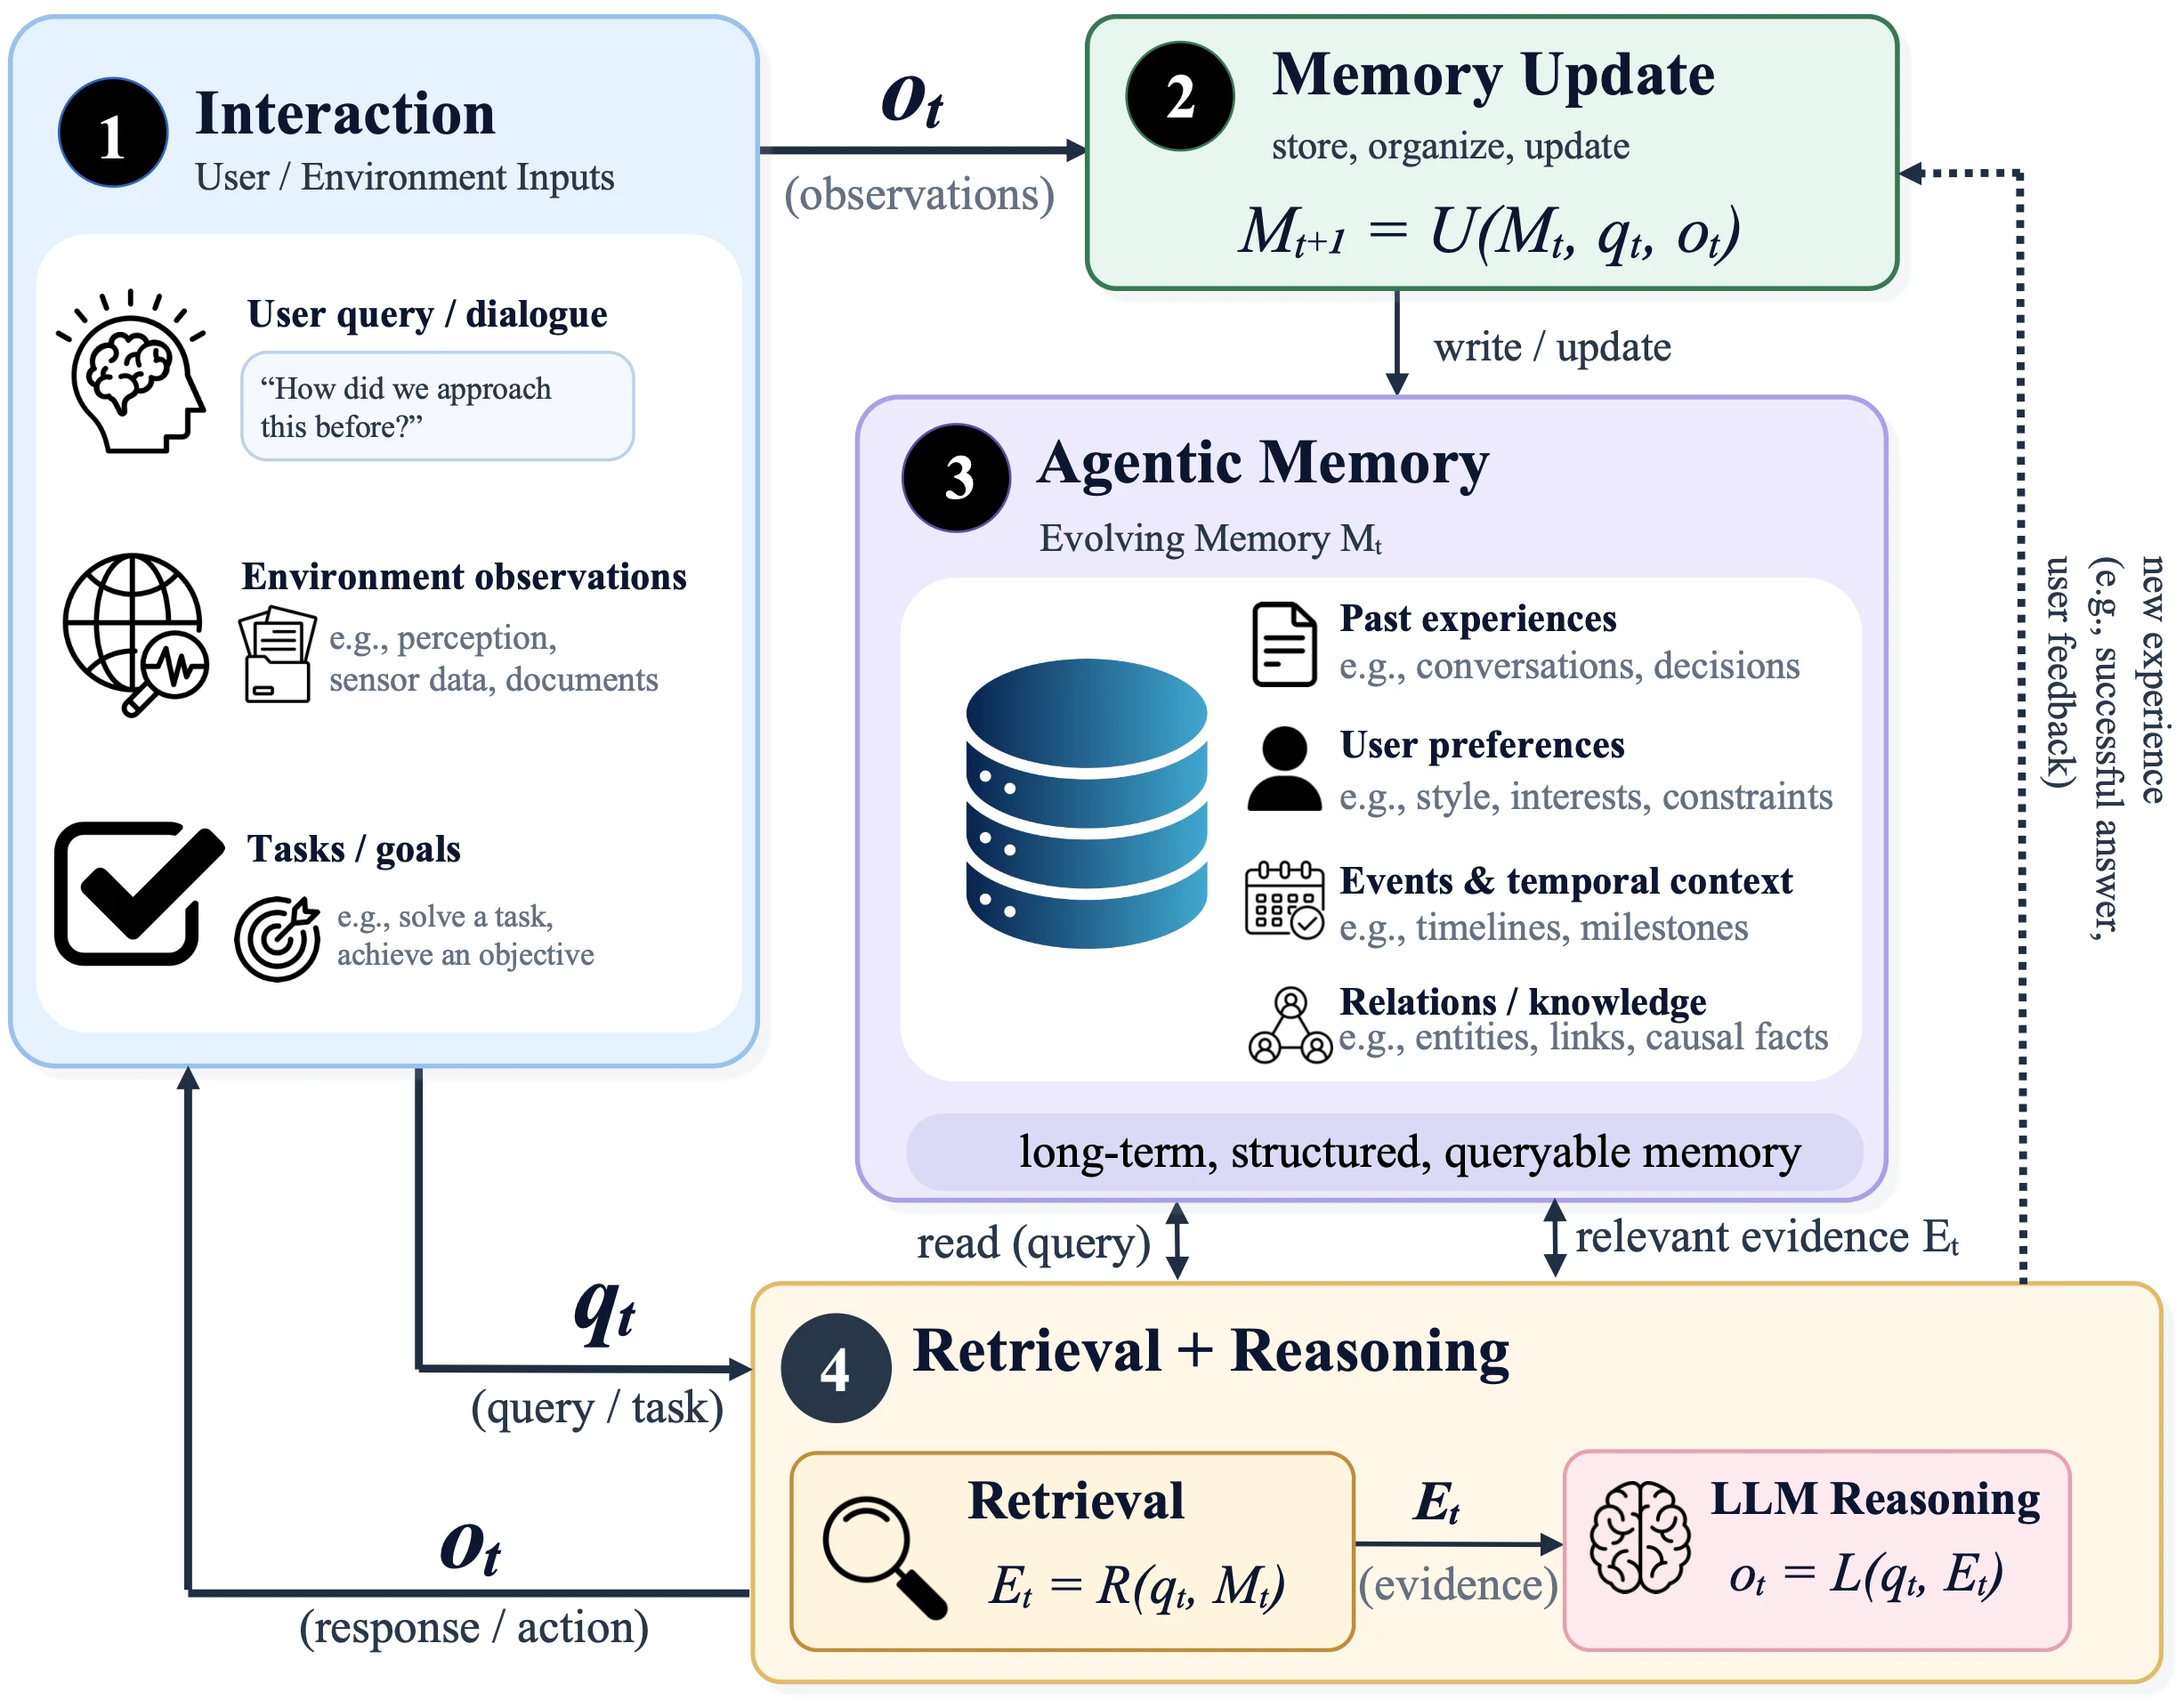
Agentic memory의 기본 흐름은 세 식으로 정리돼요. 시점 $t$에서 query $q_t$로 memory $M_t$에서 evidence를 검색하고, LLM이 evidence를 바탕으로 응답을 만들고, 그 상호작용으로 memory를 갱신해요.
\[E_t = R(q_t, M_t), \quad o_t = L(q_t, E_t), \quad M_{t+1} = U(M_t, q_t, o_t)\]초기 memory는 대화를 저장하고 embedding 유사도로 꺼내는 수준이었어요. 최근 시스템은 $U$와 $R$ 안에서 많은 결정을 내려요. 쓰기 과정에서는 새 정보가 어떤 종류인지, 기존 memory와 어떻게 연결되는지 판단해요. 읽기 과정에서는 어디를 검색할지, 어떤 후보가 유용한지, 언제 검색을 멈출지 판단해요.
기존 시스템은 이 결정을 fixed heuristic이나 범용 LLM 호출로 처리해요. Heuristic은 빠르지만 query에 따라 유연하게 바뀌지 않아요. LLM은 유연하지만 판단마다 token을 생성해야 해요. 이런 결정은 memory의 critical path에 반복해서 나타나기 때문에 비용이 누적돼요.
저자들의 핵심 관찰은 memory 제어 결정이 semantic하지만 generative하지 않다는 점이에요. “두 memory가 인과 관계인가”, “지금 evidence로 답할 수 있는가” 같은 질문의 출력은 label, 확률, score처럼 범위가 정해져 있어요. 이런 결정에 autoregressive generation을 쓰면 token 생성, 출력 formatting, parsing 비용을 불필요하게 내게 돼요.
누구나 떠올릴 수 있는 아이디어이긴 하지만, 말도 안 되게 빨리 논문을 냈다보니 앞으로 Jev를 평가하는데 좋은 baseline 역할을 해줄 것 같아요.
System One과 System Two로 역할을 나눈다
저자들은 dual-process 이론의 System One(빠르고 자동적인 처리)과 System Two(느리고 숙고하는 처리)를 가져와요. Memory typing, relation 판단, query routing, 후보 scoring, 중단 판단은 System One에, evidence 종합과 최종 답변 생성은 System Two에 배정해요. 여기서 System One 역할은 Jev가 맡아요. Jev는 auto-regressive generation 없이 typed probabilistic decision을 반환해요.
Jev-Mem은 세 개의 plane으로 구성된다
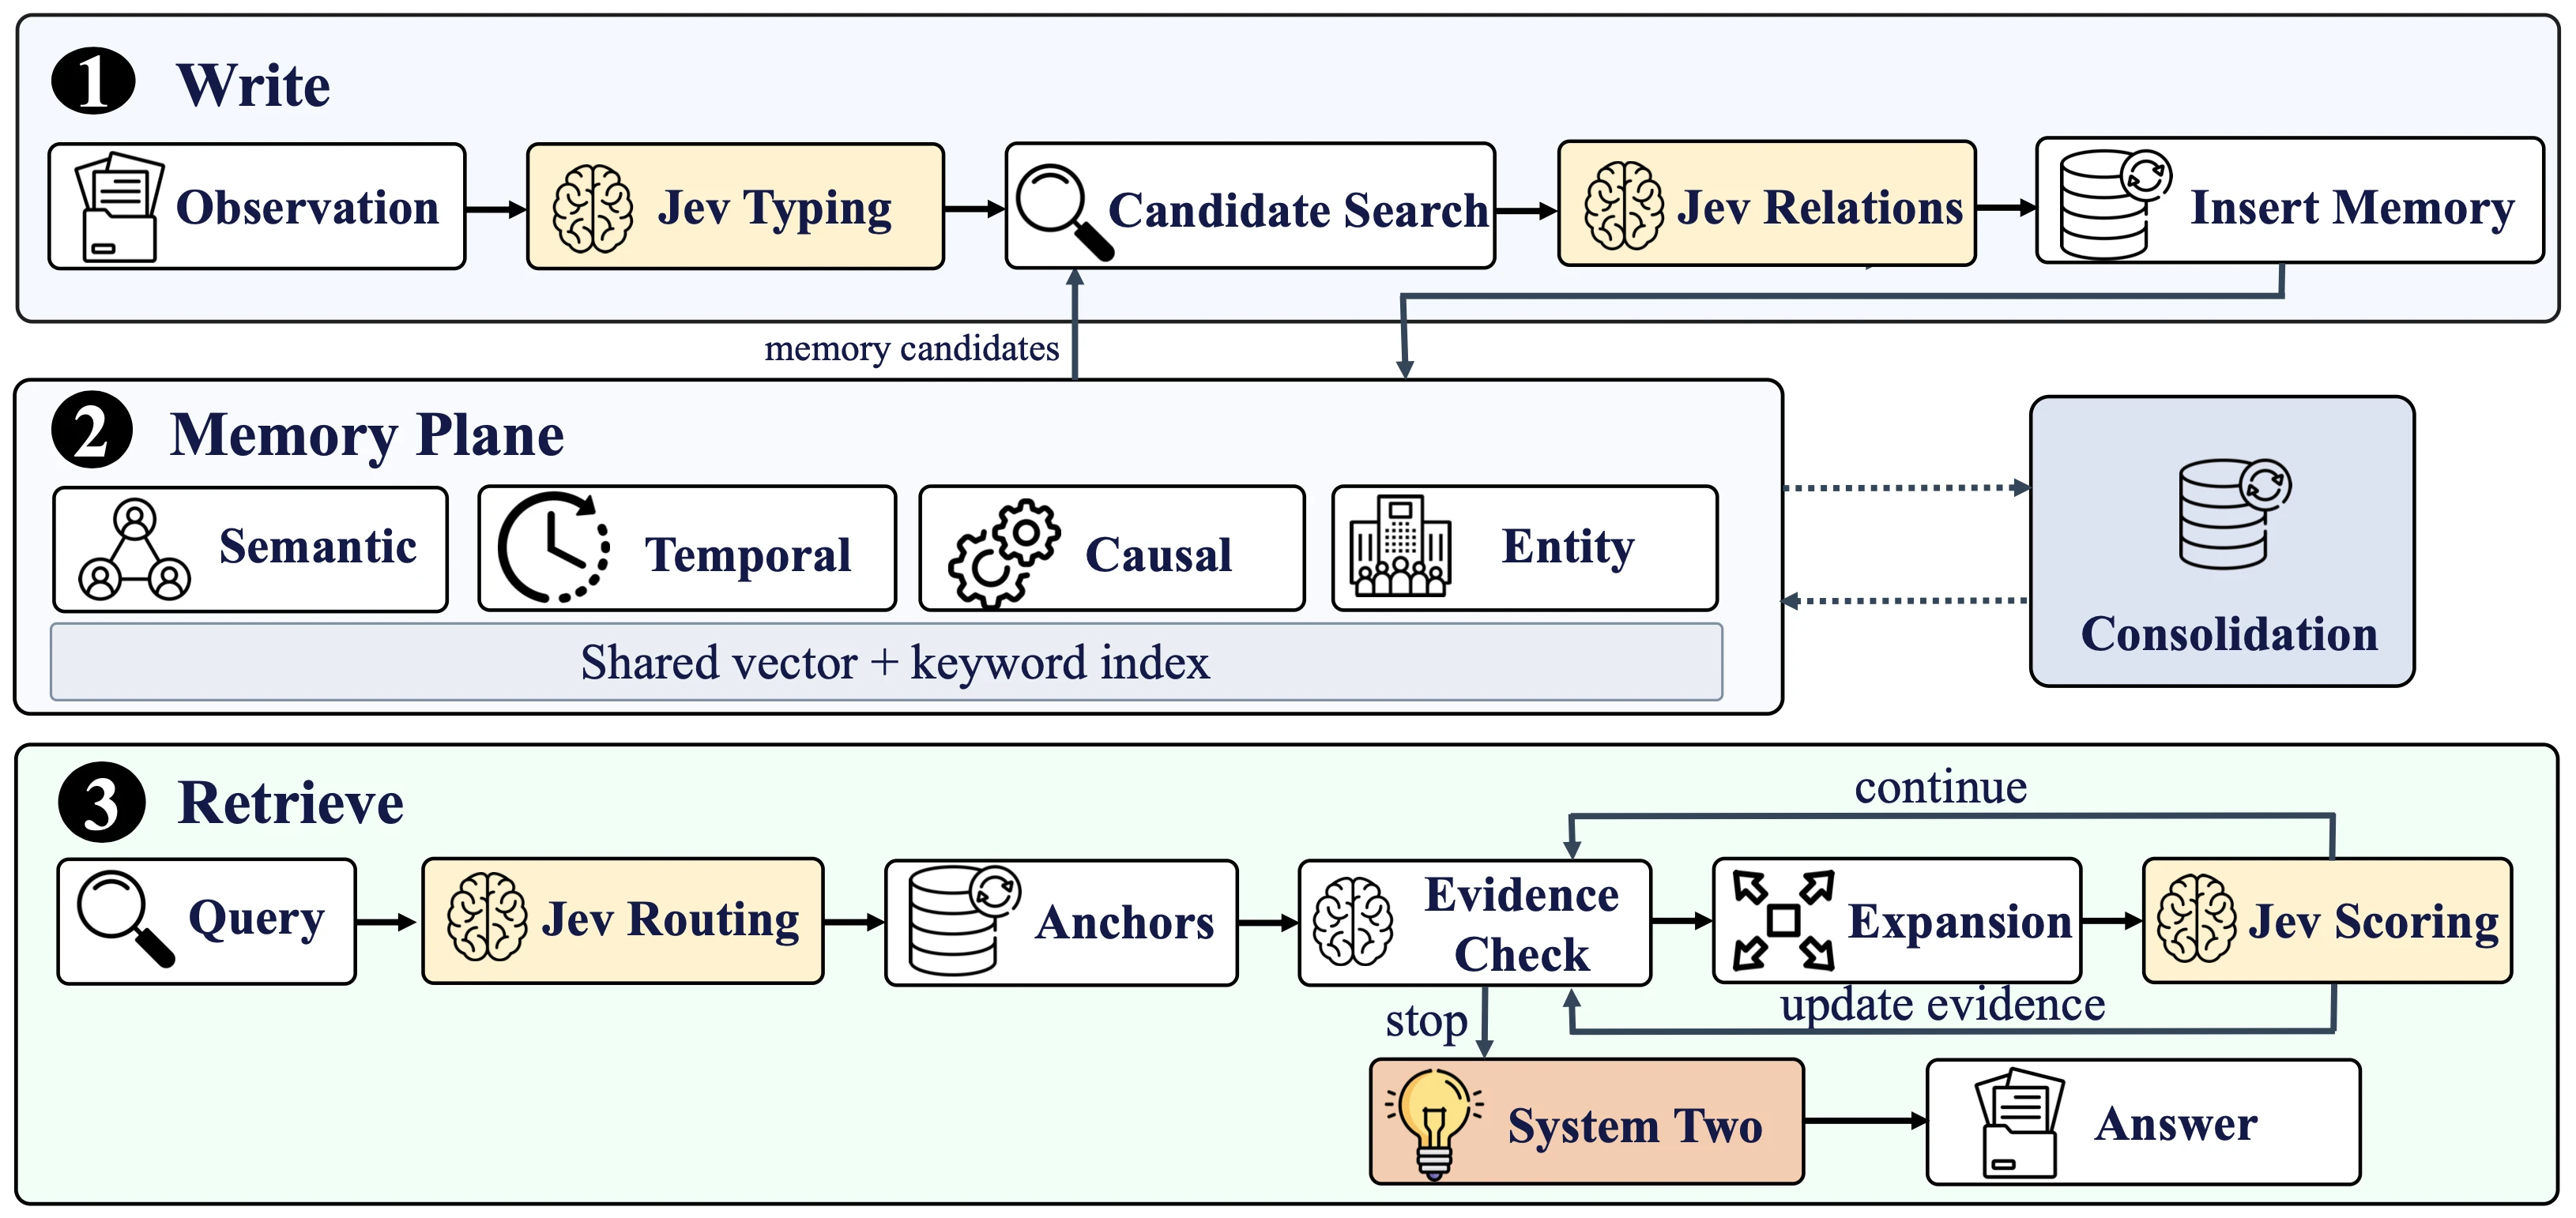
Figure 2는 세 줄로 구성돼요. 위의 Write는 쓰기 경로, 가운데 Memory Plane은 저장소, 아래 Retrieve는 읽기 경로예요. 이 그림을 역할 기준으로 다시 나누면 세 plane이 돼요.
- System-One control plane은 그림에서 이름에 Jev가 붙은 상자(Jev Typing, Jev Relations, Jev Routing, Jev Scoring)와 Evidence Check예요. 쓰기와 읽기의 결정을 모두 이 plane이 맡아요.
- Memory plane은 가운데 줄이에요. Semantic, Temporal, Causal, Entity 상자와 Shared vector + keyword index, Consolidation이 여기에 속해요.
- System-Two reasoning plane은 아래 줄의 System Two 상자예요. 검색이 끝난 뒤 답변을 생성할 때만 호출돼요.
Memory plane에 들어가는 observation은 내용 $x_t$, timestamp $\tau_t$, 출처 $\mu_t$로 표현해요.
\[o_t = (x_t, \tau_t, \mu_t)\]Memory plane 전체는 다음 식으로 표현해요.
\[\mathcal{M}_t = \left(V_t, \{E_t^g\}_{g \in \mathcal{G}}, I_t^{\text{vec}}, I_t^{\text{lex}}\right), \quad \mathcal{G} = \{\text{semantic}, \text{temporal}, \text{causal}, \text{entity}\}\]식의 각 기호는 그림의 가운데 줄과 다음처럼 대응돼요.
- $V_t$는 memory 노드 집합이에요. 쓰기 경로의 Insert Memory 단계에서 observation 하나가 노드 하나로 추가돼요.
- $E_t^g$는 관계 종류 $g$의 edge 집합이고, 그림의 Semantic, Temporal, Causal, Entity 상자 각각에 해당해요. 이 글에서는 논문을 따라 각 $E_t^g$를 view라고 불러요.
- $I_t^{\text{vec}}$와 $I_t^{\text{lex}}$는 그림의 Shared vector + keyword index예요. 읽기 경로에서 검색 시작점(Anchors)을 찾을 때 써요.
네 view는 모두 같은 노드 집합 $V_t$ 위에 정의돼요. 그래서 한 노드 쌍 사이에 semantic edge와 causal edge가 동시에 있을 수 있고, observation을 view마다 복제하지 않아요. 이 구조는 MAGMA와 같고, Jev-Mem이 바꾼 부분은 view를 만들고 탐색하는 제어 방식이에요.
Typed controller는 확률만 반환해요
Controller는 $\mathcal{J}(S, \mathcal{Q})$로 표기해요. $S$는 구조화된 state이고, $\mathcal{Q}$는 한 번에 묻는 결정 질문의 batch예요. 질문은 두 종류예요.
- Noul은 이진 명제예요. Instruction과 true/false 기준을 주면 $[0, 1]$ 값을 반환해요. 여러 Noul은 서로 독립된 명제로 평가되므로, 한 observation이 episodic이면서 semantic일 수 있어요.
- Choice는 상호 배타적인 선택지 중 하나를 고르고 선택지별 분포를 반환해요. 시간 관계(before, after 등)나 consolidation 방식 선택에 써요.
요청 구조를 단순화하면 다음과 같아요.
state = {"query": "When did Mira buy a new bicycle, and why?"}
questions = [
    Noul(id="temporal",
         instruction="Does answering query require event dates, durations, ordering ...?",
         true="A time relation is needed to answer correctly.",
         false="Dates or ordering are incidental to the answer."),
    Noul(id="causal", ...),
    Noul(id="multi_hop_need", ...),
    ...
]
scores = client.system_one(state, questions)  # {"temporal": 0.9, "causal": 0.8, ...}
같은 state를 공유하는 질문은 한 번의 호출로 묶어서 평가해요. 저자들은 반환값이 calibrated probability라고 가정하지 않는다고 밝혀요. 이후 등장하는 threshold는 이 점수에 대해 경험적으로 정한 값이에요.
일단 저장해 놓고 선택해서 쓰자
Jev-Mem은 유효한 observation을 모두 저장해요. 저장 시점에 “중요하지 않다”고 판단해 버리면, 나중 query에서 필요해져도 복구할 수 없기 때문이에요. 선택은 저장 여부가 아니라 관계를 만들 때와 검색할 때 이뤄져요.
Typing과 후보 탐색
먼저 controller가 네 가지 type score를 예측해요.
\[t(v) = (t_{\text{episodic}}, t_{\text{semantic}}, t_{\text{procedural}}, t_{\text{preference}})\]이 점수는 노드를 한 category에 배정하지 않고 annotation으로 붙어요. 노드는 원문, 출처, timestamp, embedding, entity, type score를 함께 보관해요.
다음은 새 노드를 기존 memory와 연결하는 단계예요. 모든 기존 노드와 비교하면 controller 비용이 memory 크기에 비례해 커져요. Jev-Mem은 후보 탐색과 관계 판단을 분리해요. Vector 유사도, lexical overlap, 공유 entity, 시간 근접성을 결합한 deterministic score로 최대 $K_w$개(구현값 10)의 후보를 먼저 골라요.
\[C(v) = \mathrm{TopK}_{u \in V_t} \, s_{\text{cand}}(v, u)\]Controller는 이 후보 쌍만 평가하므로 호출 비용이 $K_w$로 제한돼요.
Relation 판단
각 후보 쌍 $(v, u)$에 대해 controller는 semantic 관련성, 양방향 인과(caused_by, causes), 같은 episode 여부를 평가하고, 필요할 때만 entity alias를 판단해요. 구조화된 정보로 결정할 수 있는 관계는 learned inference를 쓰지 않아요. Timestamp 순서가 있으면 temporal edge를, entity identifier가 정확히 일치하면 entity edge를 바로 만들어요. 시간 순서가 암묵적일 때만 controller가 before, after, during, contains, overlaps, same_time, unknown 중 하나를 골라요.
추론된 edge는 확률이 threshold를 넘을 때만 추가해요. 구현에서 $\theta_{\text{rel}} = 0.60$이에요.
\[P(g \mid v, u) \geq \theta_{\text{rel}}\]논문의 예시로 보면 이해가 쉬워요. $m_1$은 5월 14일 “Mira: My old bicycle broke.”, $m_2$는 5월 16일 “Mira: I bought a new bicycle yesterday because my old one broke.”예요. $m_2$가 들어오면 $m_1$이 후보가 되고, controller는 semantic 관계와 $m_1 \to m_2$ 방향의 caused_by 관계를 평가해요. Causal 기준에는 “주제가 같거나 시간 순서만 있는 경우는 false”가 명시돼 있어서, 단순 연관을 인과로 잘못 연결하는 것을 막아요. Mira와 bicycle은 identifier가 정확히 일치하므로 entity edge는 controller 없이 만들어져요.
쓰기 경로 전체는 다음과 같아요. 일반적인 쓰기 한 번에 Jev 호출은 두 번이에요. 네 type score($t_{\text{episodic}}$ 등)를 한 batch로 묻는 typing 호출 1회와, 최대 $K_w$개 후보 쌍의 관계를 한 batch로 묻는 relation 호출 1회예요.
\[o_t \rightarrow \text{type} \rightarrow \text{candidates} \rightarrow \text{relations} \rightarrow \mathcal{M}_t\]Consolidation
20번의 쓰기마다 제한된 이웃 범위에서 redundancy, contradiction, obsolescence, link usefulness를 Noul로 평가하고, Choice로 { keep_separate, merge, promote, uncertain } 중 표현 방식을 골라요. 이 과정은 결정과 link를 기록할 뿐 원본 memory를 대체하지 않아요. Merge나 promote의 확률이 0.85 이상이고 contradiction 점수가 0.85 미만일 때만 System Two가 요약된 새 표현을 생성해요. 생성은 기본 메커니즘이 아니라 구조화된 결정의 결과로 선택적으로 호출돼요.
읽기 경로는 검색을 closed loop로 만든다
Jev-Mem은 검색을 한 번의 top-$k$ search가 아니라, 판단과 확장을 반복하는 제어 과정으로 다뤄요.
Routing과 budget 배분
Controller는 query $q$에 대해 relational view별 필요도, multi-hop 필요도 $h(q)$, 최신성 중요도 $r(q)$를 예측해요.
\[\mathbf{p}(q) = \{p_g(q)\}_{g \in \mathcal{G}}\]각 view의 필요도는 서로 독립적으로 평가되므로, query 하나가 여러 view를 동시에 활성화할 수 있어요. View는 $p_g(q) \geq \theta_{\text{act}}$일 때 활성화되고, 구현값은 $\theta_{\text{act}} = 0.10$이에요. 활성화된 view의 집합을 $A(q)$라고 해요.
다음은 탐색 노력을 나누는 단계예요. Budget $B$는 한 query에서 허용하는 이웃 노드 확장 횟수의 총량이고, 구현값은 80이에요. 이 80회를 활성 view에 필요도 비율대로 나눠요. 먼저 view별 가중치 $w_g(q)$를 계산해요.
\[w_g(q) = \frac{p_g(q)^\gamma}{\sum_{j \in A(q)} p_j(q)^\gamma}\]$\gamma$는 배분을 얼마나 몰아줄지 정해요. $\gamma > 1$이면 필요도가 가장 높은 view에 budget이 몰리고, $\gamma < 1$이면 고르게 퍼져요. 구현값은 $\gamma = 1$이라서 필요도에 단순 비례해요.
그다음 각 활성 view에 최소 $m$회(구현값 1)를 먼저 보장하고, 남은 budget을 비율대로 나눠요.
\[b_g = m + \mathrm{LRound}_g\left[(B - m|A(q)|) \, w_g(q)\right]\]$\mathrm{LRound}$는 largest-remainder rounding이에요. 각 몫의 정수 부분을 먼저 주고, 남은 횟수는 소수 부분이 큰 view부터 1씩 줘요. 이렇게 하면 반올림 후에도 합이 정확히 budget과 같아요.
마지막으로 탐색 깊이, 즉 anchor에서 몇 hop까지 나갈지를 multi-hop 필요도 $h(q)$로 정해요.
\[D(q) = \min\left\{D_{\max}, \max\left(1, \lceil D_{\max} \, h(q) \rceil\right)\right\}\]최대 깊이 $D_{\max}$에 $h(q)$를 곱해 올림한 값이 기본 값이예요. $\max(1, \cdot)$는 최소 1 hop을 보장하고, $\min(D_{\max}, \cdot)$는 상한을 넘지 않게 해요.
도움이 안 될 view에 같은 노력을 쓰지 않으면서, 여러 종류의 evidence가 필요한 query는 여러 view를 탐색할 수 있게 하는 설계예요.
Anchor 검색
그래프를 따라 이웃을 확장하려면 먼저 출발할 노드가 필요해요. 이 출발 노드를 anchor라고 해요. Jev-Mem은 query로 vector 검색(embedding 유사도)과 keyword 검색(단어 일치)을 각각 수행하고, 두 순위 목록을 reciprocal-rank fusion(RRF)으로 합쳐 anchor를 골라요.
\[s_{\text{RRF}}(v, q) = \sum_{L \in \{L_{\text{vec}}, L_{\text{lex}}\}: v \in L} \frac{1}{\kappa + \mathrm{rank}_L(v)}, \quad \kappa = 60\]$L_{\text{vec}}$와 $L_{\text{lex}}$는 두 검색의 결과 목록이고, $\mathrm{rank}_L(v)$는 목록 $L$에서 노드 $v$의 순위예요. RRF는 점수 대신 순위만 써요. Embedding 유사도와 keyword 점수는 척도가 달라 직접 더하기 어렵기 때문이에요. 순위가 높을수록 $1/(\kappa + \mathrm{rank})$가 커지고, 두 목록에 모두 등장한 노드는 두 값을 더해 받아요. 따라서 한쪽에서만 1등인 노드보다 양쪽에서 모두 상위인 노드가 anchor로 뽑히기 쉬워요. $\kappa$는 상위 순위 간 점수 차이를 완화하는 상수로, 60은 RRF에서 흔히 쓰는 값이에요.
Evidence 평가와 중단
매 round $d$가 끝나면 controller가 현재 evidence $E_d$에 대해 네 값을 추정해요.
- $s_d$는 evidence sufficiency예요. Query의 모든 사실적 요소가 evidence로 뒷받침되는지 판단해요.
- $u_d$는 검색을 더 하는 것의 기대 효용이에요. 특정 공백이나 충돌을 채울 수 있는지 판단해요.
- $m_d$는 필요한 evidence가 빠졌는지, $c_d$는 해결되지 않은 모순이 있는지 나타내요.
검색은 다음 조건을 만족되면 끝나요.
\[\left(s_d \geq \theta_{\text{suff}} \wedge m_d < \theta_{\text{cont}} \wedge c_d < \theta_{\text{cont}}\right) \vee \left(u_d < \theta_{\text{cont}}\right)\]구현값은 $\theta_{\text{suff}} = 0.95$, $\theta_{\text{cont}} = 0.15$예요. 앞의 조건은 evidence가 충분할 때, 뒤의 조건은 evidence가 불완전하더라도 더 찾아도 나아지지 않을 때 멈추는 규칙이에요. 너무 일찍 멈추면 필요한 evidence를 놓치고, 멈추지 않으면 관련 없는 memory가 섞여 System Two의 추론을 방해해요. 두 조건은 이 균형을 명시적으로 다뤄요. 여기에 depth 8, 방문 노드 60, 검사 edge 2400, Jev 호출 16회, 시간 15초의 독립적인 상한이 걸려 있어요. 이 상한에 걸리면 evidence가 불완전해도 검색이 끝나요.
Temporal query에서는 evidence에 timestamp_role과 temporal_references를 함께 넘겨요. Timestamp가 발화 시점인지 사건 시점인지를 구분하기 위해서예요. $m_2$는 5월 16일에 관찰됐지만, “yesterday”라는 표현 때문에 실제 구매일은 5월 15일이에요.
후보 scoring
Evidence가 부족하면 relation별 budget $b_g$ 안에서 이웃 노드를 확장해요. Controller는 각 후보 $v$에 대해 query 관련성 $a_v$, relation 유용성 $\ell_v$, 새로운 정보량 $n_v$, 현재 evidence 지지 정도 $c_v$를 평가해요. 이 값을 embedding 유사도 $z_v$, 저장된 edge 가중치 $\pi_e$와 결합해요.
\[s(v \mid q, E_d) = \frac{1}{\sum_{i=1}^{5} \lambda_i}\left(\lambda_1 z_v + \lambda_2 a_v + \lambda_3 p_g(q) \ell_v + \lambda_4 n_v + \lambda_5 \frac{\pi_e + c_v}{2}\right)\]Relation 유용성 $\ell_v$에 해당 view의 routing 확률 $p_g(q)$를 곱한 것이 핵심이에요. 같은 causal edge라도 query가 인과 설명을 요구하지 않으면 가중치가 작아져요. Timestamp가 있으면 query별 최신성 중요도로 점수를 조정해요.
\[\rho_v = \frac{1}{1 + \max(0, \tau^* - \tau_v)/\text{day}}, \quad \tilde{s}(v) = \frac{s(v) + 0.1 \, r(q) \rho_v}{1 + 0.1 \, r(q)}\]상위 $W$개(구현값 10)가 다음 beam이 되고 evidence에 추가돼요. 검색은 다음 loop를 반복해요.
\[\text{route} \rightarrow \text{retrieve} \rightarrow \text{assess} \rightarrow \text{expand} \rightarrow \text{reassess}\]검색이 끝나면 상위 $K$개 memory만 System Two에 넘겨 답변을 생성해요.
\[y = \text{SystemTwo}(q, E)\]System Two는 routing, 확장, 중단 결정에 관여하지 않아요. Query 하나에 필요한 controller 호출은 routing 1회와, round마다 evidence 평가 최대 1회와 후보 scoring 최대 1회예요.
정확도와 속도가 함께 좋아졌다
실험은 LoCoMo에서 진행했어요. LoCoMo는 매우 긴 multi-session 대화에서 temporal, causal, cross-session 추론이 필요한 질문을 담은 benchmark예요. Answer 모델은 gpt-4o-mini이고, baseline은 Full Context, A-MEM, MemoryOS, Nemori, MAGMA예요. 정확도는 LLM-as-a-Judge 점수로, 효율은 전체 memory 구축 시간과 query당 평균 latency로 측정해요.
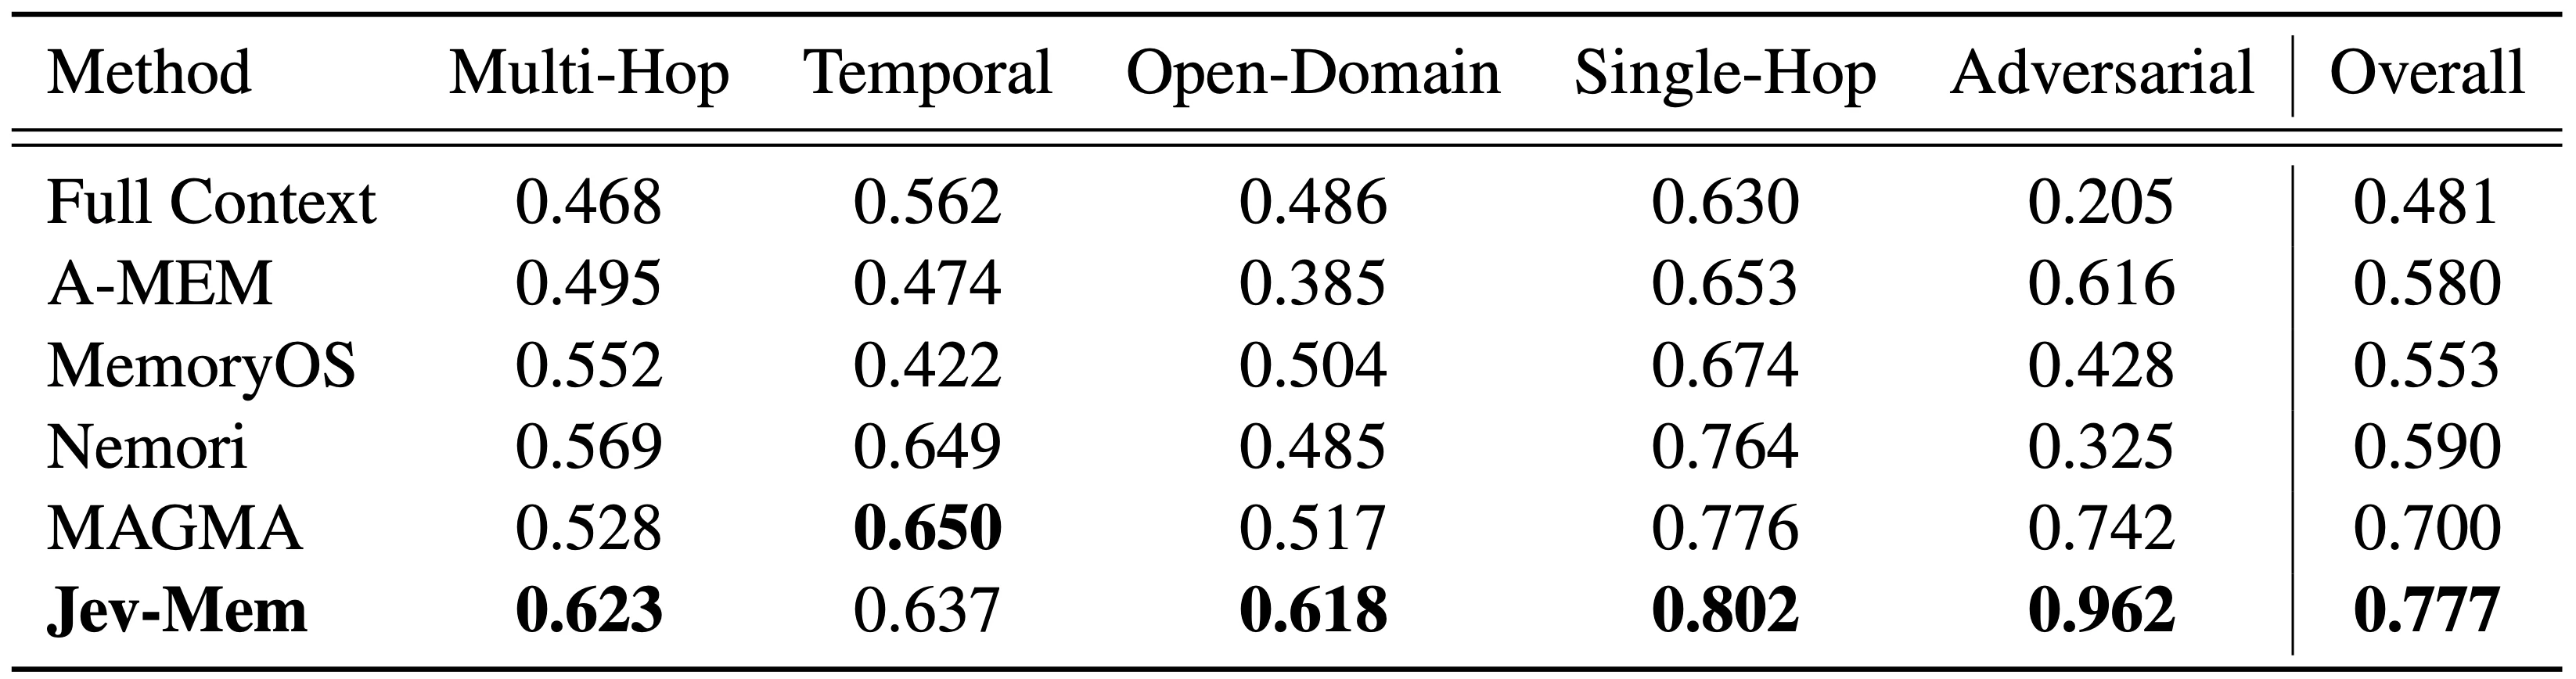
Jev-Mem의 overall 점수는 0.777로, 가장 강한 baseline인 MAGMA(0.700)보다 11.0% 높아요. Category별로 보면 다음과 같아요.
- Adversarial에서 차이가 가장 커요. MAGMA 0.742, Jev-Mem 0.962예요. Full Context는 0.205로, 긴 context를 그대로 넣는 방식이 이 category에서 약하다는 점도 확인돼요.
- Open-Domain은 0.517에서 0.618로, Multi-Hop은 0.569(Nemori)에서 0.623으로 올랐어요.
- Single-Hop은 0.776에서 0.802로 소폭 올랐어요.
- Temporal은 0.637로 MAGMA(0.650)와 Nemori(0.649)보다 조금 낮아요.
효율 차이는 더 커요.
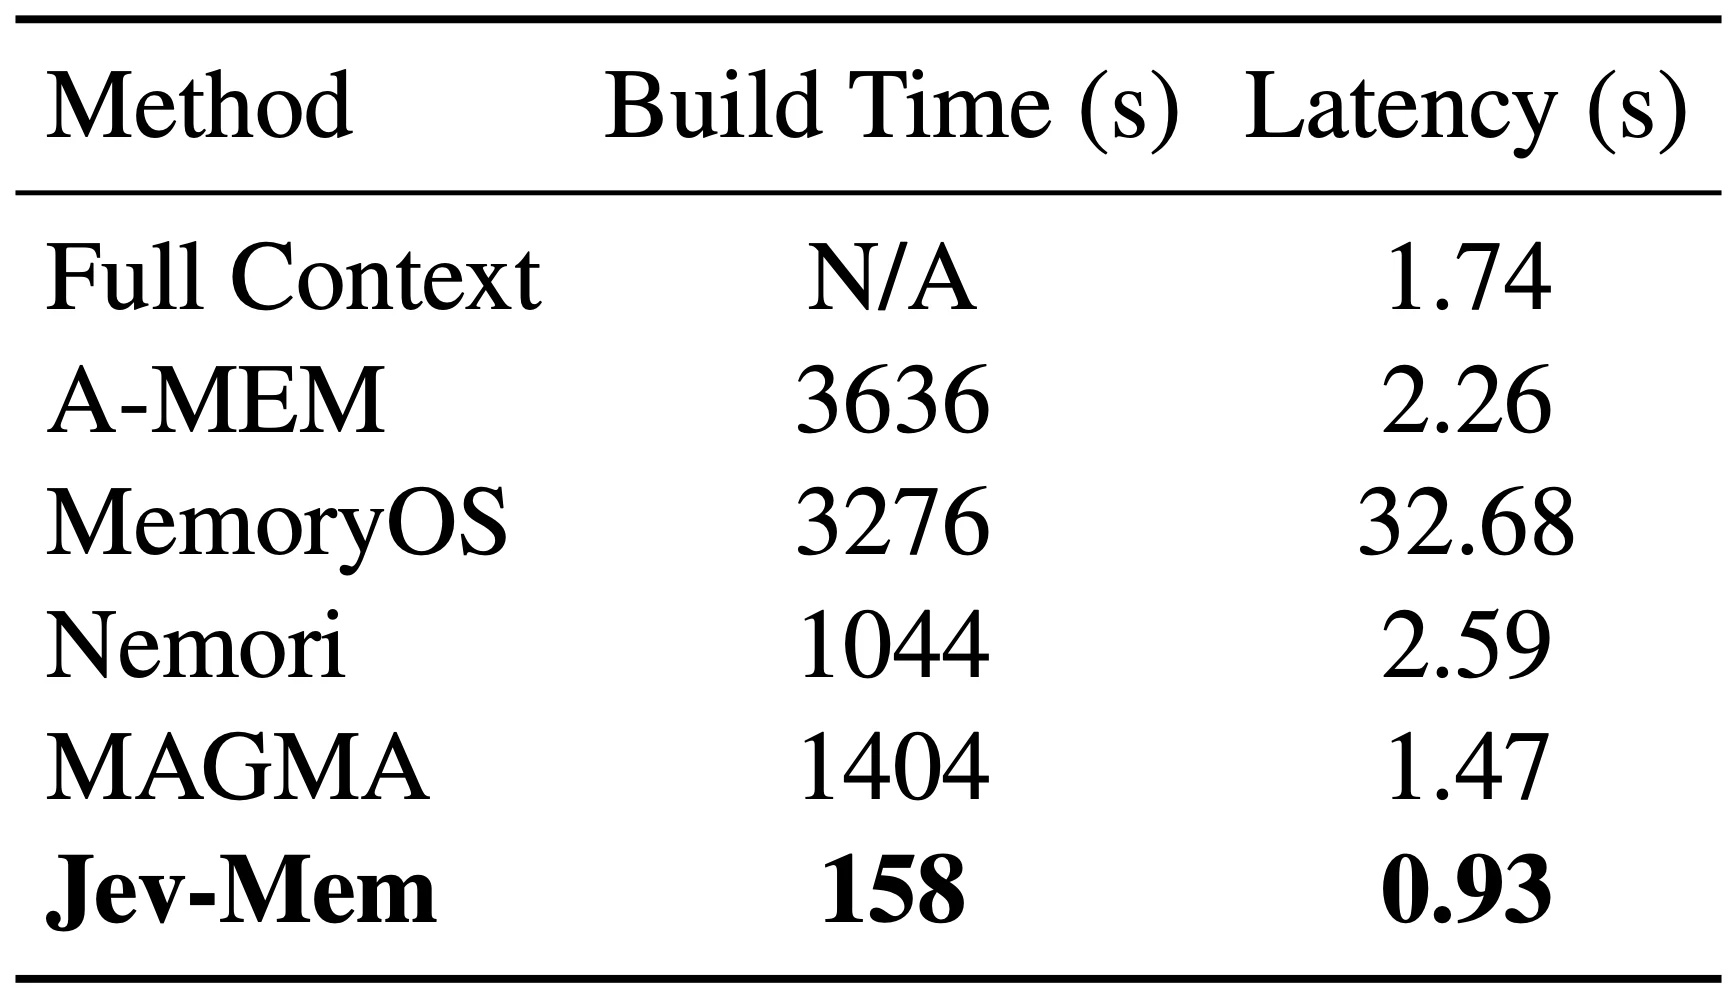
Memory 구축 시간은 158초로, 가장 빠른 baseline인 Nemori(1,044초)보다 84.9% 짧아요(6.6배). A-MEM과 MemoryOS는 3,000초가 넘어요. Query당 latency는 0.93초로 MAGMA(1.47초)보다 36.7%, Full Context(1.74초)보다 46.6% 낮아요. MemoryOS는 32.68초로, 검색 경로에 복잡한 처리가 남아 있을 때 overhead가 얼마나 커지는지 보여줘요.
결과를 어떻게 해석할까
효율 향상의 원인은 비교적 명확해요. Jev-Mem의 memory plane은 MAGMA와 같은 구조이므로, 구축 시간 차이(1,404초 → 158초)는 대부분 제어 방식에서 나온다고 볼 수 있어요. 쓰기마다 LLM으로 자유 형식 텍스트를 생성하고 parsing하던 과정을, bounded 후보 집합에 대한 batch 확률 판단 두 번으로 바꾼 효과예요. Timestamp와 entity처럼 구조화된 정보로 결정되는 관계를 learned inference에서 뺀 것도 비용을 줄여요. Latency 감소는 routing으로 탐색 범위를 줄이고 adaptive stopping으로 불필요한 round를 건너뛴 결과로 해석돼요.
정확도 향상은 evidence 선택이 정교해진 덕분이라고 저자들은 설명해요. Query마다 필요한 view를 고르고, 후보를 관련성과 새로운 정보량으로 걸러내고, 충분할 때 멈추기 때문에 System Two가 더 작고 관련성 높은 evidence를 받는다는 주장이에요. Adversarial의 큰 향상도 이 관점과 맞아요. 이 category는 그럴듯하지만 근거가 없는 질문을 담고 있어서, evidence가 답을 뒷받침하는지 엄격하게 판단하는 것이 중요해요. Sufficiency threshold 0.95와 “주제가 겹치는 것만으로는 관련 있다고 보지 않는다”는 relevance 기준이 방해 정보를 줄였을 가능성이 있어요. 다만 이는 설계에서 추론한 해석이고, 논문이 직접 검증하지는 않았어요.
Temporal에서 향상이 없는 점도 설계와 연결해서 볼 수 있어요. Temporal edge는 대부분 timestamp로 deterministic하게 만들어지므로 MAGMA와 크게 다르지 않아요. Controller가 개입하는 부분은 암묵적 시간 순서 판단과 temporal evidence의 충분성 판단 정도예요.
결과를 일반화하기 전에 확인할 점도 있어요.
- 평가가 LoCoMo 하나에서만 이뤄졌어요. LongMemEval, MemoryAgentBench처럼 성격이 다른 benchmark에서의 결과는 아직 없어요.
- Ablation이 없어요. Routing, budget 배분, 후보 scoring, adaptive stopping 중 어느 요소가 정확도에 기여했는지 분리할 수 없어요.
- Jev는 모델 정보가 공개되지 않은 외부 서비스예요. 재현성은 이 서비스의 가용성에 의존하고, API 비용이나 token 사용량도 보고되지 않았어요. Wall-clock latency는 서비스 인프라의 영향을 받기 때문에 baseline과의 비교가 완전히 동일한 조건이라고 보기 어려워요.
- Threshold가 많지만($\theta_{\text{rel}}$, $\theta_{\text{act}}$, $\theta_{\text{suff}}$, $\theta_{\text{cont}}$, budget, beam width 등) 민감도 분석이 없어요. 반환값이 calibrated probability가 아니라고 저자들이 직접 밝힌 만큼, 다른 controller를 쓰면 threshold를 다시 조정해야 할 가능성이 커요.
이 한계는 “제어와 추론을 분리하면 효율이 크게 좋아진다”는 핵심 결론을 뒤집지는 않아요. 구축 시간과 latency 차이는 충분히 크고, 원인도 구조에서 설명돼요. 정확도 향상이 제어 방식에서 오는지에 대해서는 추가 검증이 필요해요.
정리
Jev-Mem은 memory 관리 결정 대부분이 범위가 정해진 출력을 내는 분류 문제라는 점에 주목해요. 이 결정을 typed probabilistic controller에 맡기고, auto-regressive LLM은 최종 답변 생성과 선택적인 consolidation에만 써요. 쓰기에서는 모든 observation을 보존하면서 bounded 후보에 대해서만 관계를 판단하고, 읽기에서는 routing, budget 배분, 후보 scoring, adaptive stopping을 closed loop로 반복해요. LoCoMo에서 정확도와 효율을 함께 개선했지만, 단일 benchmark와 ablation 부재 때문에 정확도 향상의 원인은 추가 실험으로 확인할 필요가 있어요.
기존에 있던 MAGMA에 jev를 붙이기만 해도 명확한 성능 향상이 있었어요. 심지어 jev가 워나 빠르고 정확하다보니 판단이 필요한 순간에 jev를 난사해도 기존 LLM 판단을 활용한 프레임워크보다 월등히 빨랐어요. Jev의 등장으로 앞으로는 더 섬세한 gating, routing 설계가 필요해 진 것 같아요. 왜 jev를 두고 성능 좋은 if문이라 부르는지 이해가 됐어요.