Jev is a Zero-shot Reranker for Recommender Systems
Jev란 뭘까
Jev는 System One 모델을 표방해요. System One은 깊이 따져 보는 사고가 아닌, 즉각적이고 본능적인 사고 과정을 말해요. LLM 워크플로를 그래프로 구성하는 LangGraph를 써 보면 알 수 있듯이, 모델을 routing하거나 조건을 판단하는 단계에는 높은 추론 능력이 필요하지 않아요. 이런 단계에는 빠르고 저렴하게 판단하는 모델이 필요해요. Jev의 end-to-end 응답 시간은 70-500ms로, frontier LLM보다 40-200배 빠르다고 해요. 자체 workflow eval에서는 193.6배 빠르고 444.6배 저렴하다고 주장해요.
 typesafe.ai/blog/introducing-system-one-models-and-jev
Jev는 auto-regressive하게 자연어 토큰을 하나씩 반복 생성하는 방식을 쓰지 않아요. 대신 Jev로는 noul, choice, score 3가지 태스크를 수행할 수 있어요.
response = requests.post(
  data=json.dumps({
    "model": "~typesafe/jev-latest",
    "state": "Help! My payouts have been failing for 3 days.",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "Does this message convey urgency?",
        "criteria": {
          "true": "Explicitly time-sensitive",
          "false": "No urgency expressed"
        } # 'is_urgent': {... 'noul': 0.95}
      },
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing": "Payments, invoicing, refunds",
          "technical": "Bugs, outages, integrations",
          "sales": "Pricing, upgrades, new accounts"
        } # 'department': {'choice': 'billing', ...
          # 'probabilities': {'technical': 0.12, 'sales': 0, 'billing': 0.88},
          # 'confidence': 0.81}
      },
      "frustration": {
        "type": "score",
        "instructions": "How frustrated is the customer?",
        "criteria": ["Calm", "Frustrated", "Very angry"]
      } # 'frustration': {'score': 1.03, ...
        # 'probabilities': {'0': 0, '1': 0.97, '2': 0.03},
        # 'confidence': 0.95}}
    }
  })
)
state에는 판단에 필요한 context를 담고, instructions에는 모델이 판단할 내용을 적어요.
noul은 binary classification 문제에요. choice는 multi-class classification이에요. 각 항목의 probability와 confidence가 함께 나와요. score는 판단 기준을 넣으면 각 기준에 대한 확률 분포를 돌려줘요. LLM-as-a-judge를 대신하는 용도로 쓸 수 있어요 (예시).
보다시피 Jev는 새로운 모델이라기보다, 기존 classification 모델이 하던 일을 대체하는 foundation model에 가까워요. 다만 모델 아키텍처가 아직 공개되지 않아 정확한 방법론은 알 수 없어요.
저렴한 모델끼리의 비교
추천 도메인에서 Jev의 reranking 능력을 확인하려고 간단한 실험을 설계했어요. reranking은 주어진 후보의 순서를 다시 매기는 작업이에요. Amazon 데이터셋으로, 사용자의 구매 기록이 주어졌을 때 다음 구매 아이템을 예측하는 문제예요. 구체적으로는 주어진 후보 10개를 1위부터 10위까지 reranking하도록 지시해요.
데이터는 Amazon reviews를 cross-domain으로 재구성한 sungjin-code/amazon-reviews-for-llm를 사용했어요. 이 중 100개를 랜덤하게 샘플링해서 써요.
비교 모델로는 GPT-4.1-nano와 Qwen-3.5-Flash를 골랐어요. 선정 기준은 비용이에요. Jev와 API 비용이 비슷하면서도 널리 쓰이는 모델을 골랐어요. 여기에 조금 더 비싸지만 성능이 좋은 Qwen-3.8-Flash도 함께 측정했어요. 참고로 reasoning은 끄고 사용했어요.
Openrouter API 기준 비용은 다음과 같아요.
| Model | Input($) | Output($) |
|---|---|---|
| Jev-1.13 | 0.042 | 0.000 |
| Qwen-3.5-Flash | 0.065 | 0.260 |
| GPT-4.1-nano | 0.100 | 0.400 |
| Qwen-3.8-Flash | 0.150 | 0.470 |
Input/Output 가격은 1M 토큰 기준이에요.
LLM reranking에 대해
먼저 LLM reranker가 어떻게 동작하는지 살펴볼게요. 사용한 프롬프트는 다음과 같아요.
[system]
You are a recommender system.

[user]
I've interacted with the following items in the past, oldest first:
1. American Military Training Aircraft: Fixed and Rotary-Wing Trainers Since 1916
2. The Blue Angels: The US Navy's Flight Demonstration Team, 1946 to the Present (Legends of Warfare: Aviation, 13)
...
10. Basic Economics

Now there are 10 candidate items I could interact with next:
1. Varina: A Novel
2. Microsoft Azure Architect Technologies and Design Complete Study Guide: Exams AZ-303 and AZ-304
...
10. A Conflict of Visions: Ideological Origins of Political Struggles

Rank all 10 candidates by how likely each is to be what I interact with next, based on the pattern above.
You must rank every candidate exactly once, using only the numbers shown
-- do not invent items that are not in the candidate list.
Reply with only the 10 candidate numbers separated by commas, most likely first.

[Output]
2,4,6,1,7,3,5,8,9,10
모델에게 구매 기록을 주고, 후보 10개를 다음에 구매할 가능성이 높은 순서대로 출력하도록 지시해요. 모델은 가능성이 높다고 판단한 아이템의 번호를 앞에 두는 식으로 답해요. 아이템 이름 대신 번호를 쓰는 이유는 두 가지예요. 후보에 없는 아이템을 지어내는 hallucination을 막고, 출력 토큰 비용을 아끼기 위해서예요.
Jev로 reranking 하기
이번에는 Jev 방식으로 reranking을 해 볼게요. Jev로는 앞의 LLM과 같은 형태의 출력을 만들 수 없어요. 그래서 choice로 각 아이템의 probability를 받고, 이 값을 점수로 삼아 순위를 매겨요. Self-attention 기반 순차 추천 모델인 SASRec이 reranking하는 방식과 비슷해요. 구체적인 입출력은 다음과 같아요.
{
  "request": {
    "state": "A shopper has bought the following items, oldest first:
    1. American Military Training Aircraft: Fixed and Rotary-Wing Trainers Since 1916
    ...
    10. Basic Economics

    These are the 10 candidate items they might buy next:
    1. Varina: A Novel
    ...
    10. A Conflict of Visions: Ideological Origins of Political Struggles",
    "questions": {
      "pick": {
        "type": "choice",
        "instructions": "Which candidate is this shopper most likely to buy next?",
        "criteria": {
          "cand_1": "Varina: A Novel", ...
          "cand_10": "A Conflict of Visions: Ideological Origins of Political Struggles"
        }
      }
    }
  },
  "response": {
    "answers": {
      "pick": {
        "type": "choice",
        "choice": "cand_10",
        "probabilities": {
          "cand_8": 0.12,
          "cand_5": 0.05,
          "cand_1": 0.04,
          "cand_4": 0.14,
          "cand_3": 0.16,
          "cand_6": 0.16,
          "cand_9": 0.01,
          "cand_10": 0.25,
          "cand_2": 0.04,
          "cand_7": 0.03
        },
        "confidence": 0.17
      }
    }
  }
}
Jev의 choice는 ranking이 아니라 classification을 수행해요. 그래서 instruction 부분만 다르게 주고, 나머지는 같은 프롬프트를 사용했어요. 이제 출력된 probabilities로 순위를 만들어 LLM과 비교해 볼게요.
Jev가 가장 정확하고 빨라요
| Methods | HR@1 | HR@3 | HR@5 | HR@10 | NDCG@1 | NDCG@3 | NDCG@5 | latency median (ms) | latency p95 (ms) | cost_cent (¢) |
|---|---|---|---|---|---|---|---|---|---|---|
| Random | 0.12 | 0.33 | 0.48 | 1.0 | 0.12 | 0.24 | 0.30 | - | - | - |
| Overlap | 0.29 | 0.5 | 0.67 | 1.0 | 0.29 | 0.4094 | 0.4787 | - | - | - |
| Jev | 0.44 | 0.71 | 0.80 | 1.0 | 0.44 | 0.60 | 0.6356 | 332.8 | 459.0 | 0.3721 |
| Qwen3.8-flash | 0.33 | 0.55 | 0.78 | 1.0 | 0.33 | 0.4609 | 0.5569 | 1845.0 | 4400.3 | 0.8342 |
| Qwen3.5-flash | 0.30 | 0.60 | 0.77 | 1.0 | 0.30 | 0.4762 | 0.5463 | 583.4 | 869.9 | 0.3546 |
| GPT-4.1-nano | 0.26 | 0.52 | 0.65 | 1.0 | 0.26 | 0.4096 | 0.4634 | 953.5 | 1373.0 | 0.4974 |
HR@k는 정답이 상위 k개 안에 들어간 비율이고, NDCG@k는 정답의 순위까지 반영한 지표예요. P95 latency는 전체 요청의 95%가 끝나는 시간이에요.
Jev의 P95 latency는 459ms로 가장 빨랐어요. Qwen-3.5보다 47.24%, GPT-nano보다 66.57% 빨라요. 평균 응답 속도도 GPT-nano보다 약 3배 빨라요. HR@1도 0.44로 가장 높으면서 속도까지 눈에 띄게 빠르다는 점은 분명한 장점이에요.
LLM으로 Jev 따라하기
Jev의 속도 이점이 auto-regressive하게 토큰을 출력하지 않는 데서 온다고 볼 수도 있어요. 아키텍처가 공개되지 않아 정확한 이유는 알 수 없지만, 저는 그게 핵심은 아니라고 생각해요. 그래서 LLM이 forward pass를 한 번만 거쳐 reranking을 하도록 만들어 봤어요.
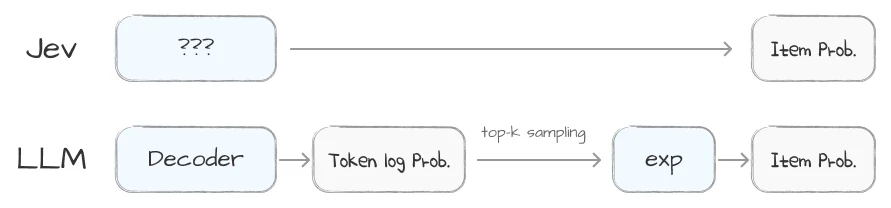
LLM에게 “다음에 구매할 아이템이 뭘까?”라고 물어요. LLM은 10개 아이템에 대해 0-9에 해당하는 인덱스로 답해요. 이때 첫 토큰의 출력 공간에서 0-9에 대한 logprob을 뽑아요. Logprob은 각 토큰이 나올 확률에 로그를 취한 값이에요. 이 값에 exp를 씌워 [0, 1] 범위로 바꾸면, auto-regressive한 출력 없이도 Jev와 같은 형태의 확률 분포를 얻을 수 있어요.
Latency를 공정하게 비교하려고 Openrouter API를 사용했어요. 다만 Qwen은 top-5 토큰의 logprob만 제공해서, 이 범위에 없는 토큰은 -inf로 처리했어요. 참고로 5번째 토큰의 출력 확률은 평균 0.035±0.03이고, 현재 관측값 중 최댓값은 0.12예요. 그래서 나머지 토큰의 출력 확률을 0으로 가정해도 전반적인 경향을 파악하는 데는 문제가 없다고 판단했어요.
| Methods | HR@1 | HR@3 | HR@5 | HR@10 | NDCG@1 | NDCG@3 | NDCG@5 | latency median (ms) | output token mean | cost_cent (¢) |
|---|---|---|---|---|---|---|---|---|---|---|
| Jev | 0.44 | 0.71 | 0.8 | 1.0 | 0.44 | 0.5986 | 0.6356 | 332.8 | 110.2 | 0.3721 |
| Qwen3.8-flash (logprob) | 0.42 | 0.66 | 0.79 | 1.0 | 0.42 | 0.557 | 0.6104 | 1321.3 | 1.0 | 0.5603 |
| Qwen3.8-flash | 0.33 | 0.55 | 0.78 | 1.0 | 0.33 | 0.4609 | 0.5569 | 1845.0 | 40.4 | 0.8342 |
Qwen3.8은 토큰 하나만 출력하게 하자 1.4배 빨라졌어요. 그래도 Jev와 비교하면 여전히 4배 가까이 느려요. 물론 같은 API라도 provider가 달라서, 같은 하드웨어에서 공정하게 비교한 결과는 아니에요. 그럼에도 API를 써야 하는 입장에서는 Jev가 여전히 매력적인 선택지일 수 있어요.
Jev를 score 방식으로 활용
| Methods | HR@1 | HR@3 | HR@5 | HR@10 | NDCG@1 | NDCG@3 | NDCG@5 | latency median (ms) | latency p95 (ms) | cost_cent (¢) |
|---|---|---|---|---|---|---|---|---|---|---|
| Jev | 0.47 | 0.72 | 0.84 | 1.0 | 0.47 | 0.6133 | 0.6628 | 313.3 | 388.7 | 0.5602 |
| Qwen3.5-flash | 0.38 | 0.61 | 0.79 | 1.0 | 0.38 | 0.5186 | 0.5921 | 1223.6 | 1687.8 | 0.6599 |
| GPT-4.1-nano | 0.30 | 0.53 | 0.71 | 1.0 | 0.3 | 0.4333 | 0.5069 | 1450.3 | 2418.1 | 0.926 |
핵심 실험은 아니지만, Jev의 score 방식도 궁금해서 시험해 봤어요. 모든 candidate item에 대해 “How likely is this shopper to buy ‘{item}’ next?”를 5점 척도로 평가하도록 했어요. LLM도 같은 방식으로, 각 아이템의 점수를 structured output으로 출력하도록 했어요.
이 방식을 쓰려면 모든 output candidate마다 5점 척도 질문을 하나하나 JSON input에 넣어야 해요. 그래서 토큰 비용이 LLM과 크게 다르지 않았어요. HR@1은 조금 올랐지만, N=100으로 진행한 실험이라 의미 있는 변화라고 확신하기는 어려워요. 무엇보다 효율성이 가장 큰 장점인 Jev에게 잘 맞는 방식은 아니라고 생각해요.
Jev에 대한 생각을 정리하며
Jev는 공개된 지 4일밖에 안 된 모델이라 더 지켜볼 필요가 있어요. 그럼에도 저렴한 비용, 빠른 속도, 준수한 성능을 고루 갖춘 매력적인 선택지라고 생각해요. 저도 agent를 설계하면서 transition이 필요한 구간마다 LLM API를 호출하는 게 부담이었는데, 앞으로는 Jev를 자주 쓰게 될 것 같아요.
다만 Jev가 늘 좋은 선택이라는 뜻은 아니에요. 복잡한 reasoning이나 긴 context를 바탕으로 판단해야 하는 경우에는 Jev가 어느 정도 성능을 낼지 아직 알 수 없어요. Context length도 Jev는 64k, Qwen-3.8은 1M으로 차이가 나요. 이번 실험도 zero-shot 환경의 결과만 담고 있어요. GPU에서 LLM을 직접 서빙할 수 있다면, downstream task에 맞춰 fine-tuning한 모델이 효율과 성능 면에서 더 유리할 수 있어요.
이번 기회를 통해 system one foundation model에 대한 수요가 분명하다는 걸 확인했어요. 앞으로 efficient language model의 수요와 맞물려, decoder 기반 LLM이 아닌 encoder 기반의 범용 foundation model이 다양하게 시도될 거라 기대해요.