Useful Memories Become Faulty When Continuously Updated by LLMs
Useful Memories Become Faulty When Continuously Updated by LLMs, arXiv 2026, arXiv.
Agentic memory 시스템의 기본 가정은 단순해요. 에이전트가 문제를 풀고 나면 그 trajectory를 LLM이 텍스트 lesson으로 요약해서 memory bank에 저장하고, 새 경험이 들어올 때마다 그 bank를 갱신해요. 파라미터를 바꾸지 않고도 경험이 쌓일수록 좋아지는 self-improving agent를 만들 수 있다는 주장이에요. CLIN, AWM, Dynamic Cheatsheet, ACE가 모두 이 update-after-every-interaction 구조를 써요.
Useful Memories Become Faulty When Continuously Updated by LLMs (UIUC, Tsinghua)는 이 가정을 반박해요. 입력 경험이 유용한 조건에서도 consolidation을 반복하면 메모리의 효용이 올랐다가 떨어지고, 결국 no-memory baseline 아래로 내려가요. 가장 극단적인 사례에서 GPT-5.4는 memory 없이 100% 풀던 ARC-AGI 문제들을, 그 문제들의 ground-truth 해답으로 메모리를 만든 뒤에 54%만 풀어요.
이 글은 논문의 실험 결과와 분석을 중심으로 정리해요.
실험은 경험의 품질을 통제하는 데 초점이 있어요
메모리가 나빠진 이유가 “입력 trajectory가 애초에 나빴기 때문”이면 consolidation 단계를 원인으로 지목할 수 없어요. 논문은 이 반론을 배제하려고 입력이 구조적으로 유용한 설정만 써요.
- ALFWorld는 task type별 ground-truth expert trajectory 128개를, WebShop은 reward 1.0인 expert trajectory 128개를 써요.
- ARC-AGI Stream에서는 매 consolidation step마다 ground-truth solution이 주어져요. 모든 입력이 정의상 정답이에요.
- 평가 문제도 모델이 memory 없이 이미 풀 수 있다고 확인된 것들로 제한한 실험이 따로 있어요.
Memory construction은 세 regime으로 나눠요. Static-All은 전체 trajectory pool을 한 번에 요약하고, Static-Group은 task type별로 따로 요약한 뒤 이어 붙이고, Stream은 batch 단위로 계속 갱신해요. Trajectory pool이 셋 다 같기 때문에 성능 차이는 내용이 아니라 갱신 방식에서만 나와요.
ARC-AGI Stream은 논문이 새로 만든 testbed예요. Episodic buffer(문제-해답 쌍)와 Abstract store(요약된 lesson)를 분리해 두고, 매 step마다 에이전트가 Retain, Delete, Consolidate 중 하나를 고를 수 있어요. 제어 조건은 세 가지예요. Force는 매 round consolidation을 강제하고 episodic entry를 남기지 않아요. Auto는 에이전트가 직접 고르고, Episodic Management Only는 retain/delete만 허용해서 abstraction을 꺼요. 문제 family가 명시적으로 정의되어 있어서 어떤 episode들이 잘못 묶였는지 step 단위로 확인할 수 있어요.
메모리 효용은 올랐다가 떨어져요
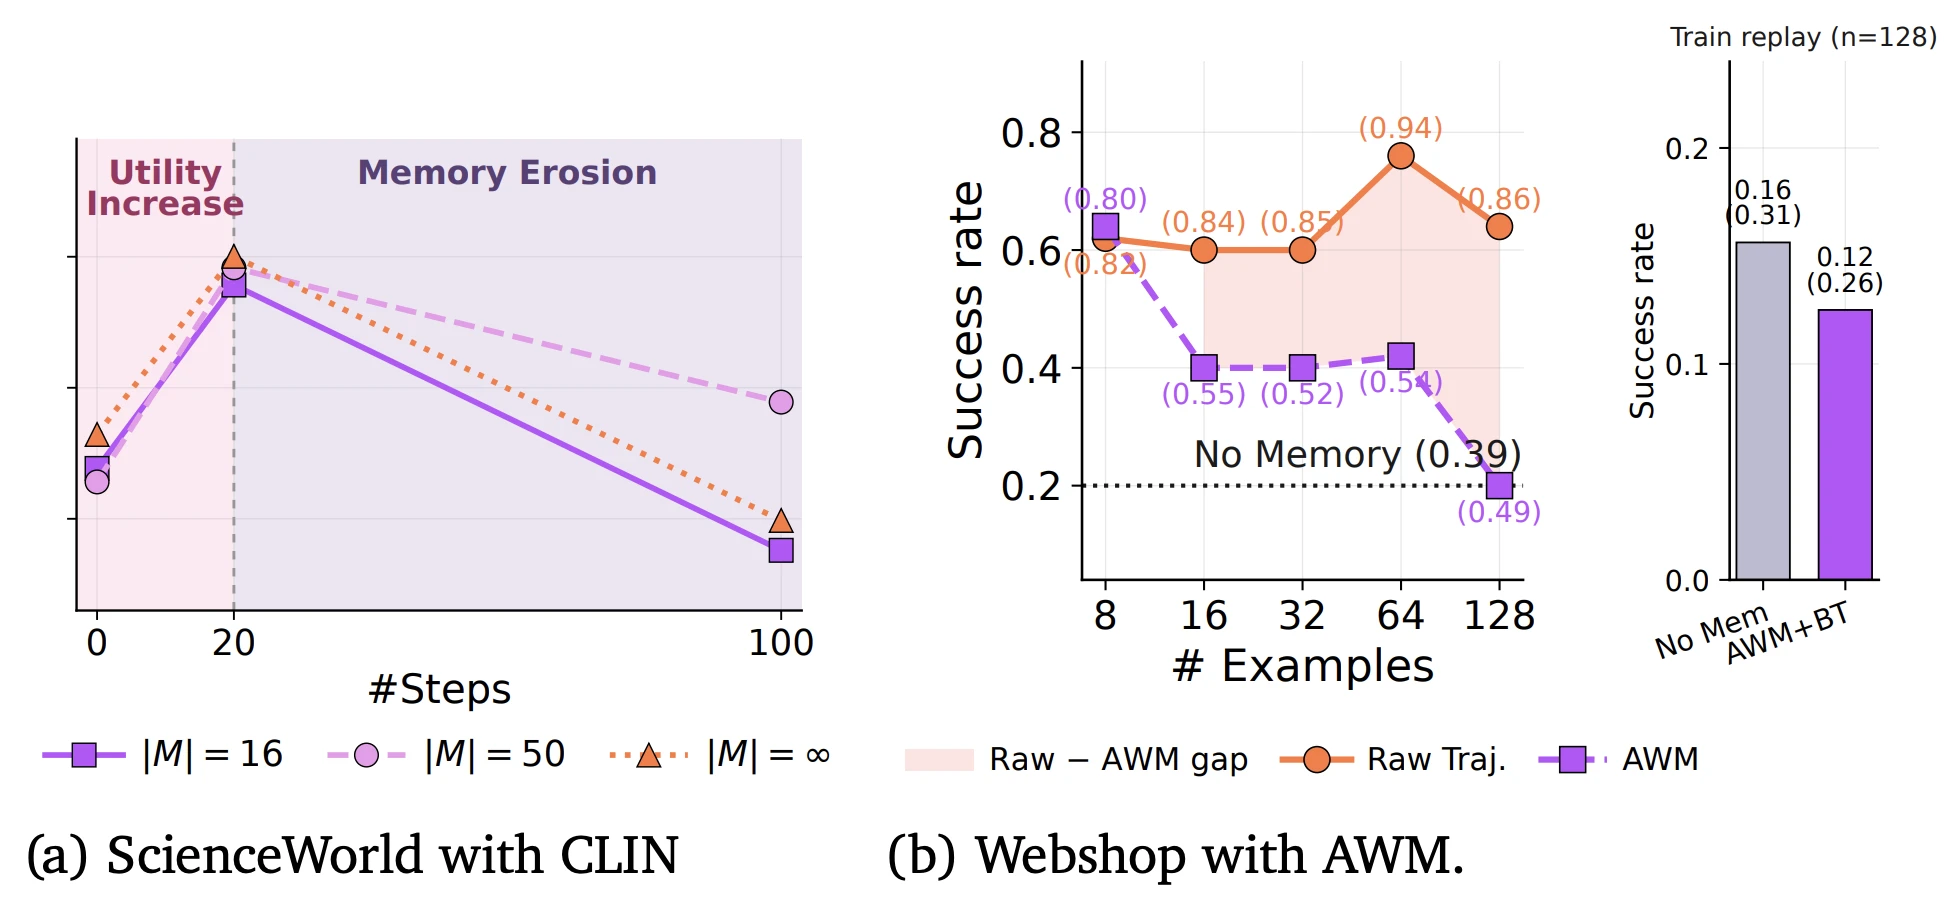
ScienceWorld에서 CLIN으로 batch 4개씩 갱신하면 score가 step 20 근처에서 최고점에 도달한 뒤 step 100까지 내려가요. 이 형태는 memory size $|M| \in {16, 50, \infty}$ 전부에서 같고, 일부 구간에서는 no-memory baseline(0.39)보다 낮아져요. Capacity 제한 때문이 아니라는 뜻이에요.
WebShop에서 AWM을 쓰면 더 선명해요. 예제 8개일 때 success rate 0.64에서 시작해 128개일 때 0.20까지 떨어지는데, no-memory가 0.20이에요. 같은 trajectory를 요약하지 않고 in-context로 넣은 raw trajectory 조건은 같은 scale에서 0.86 수준을 유지해요. 메모리를 키울수록 요약의 이득이 사라져요.
잘 만든 메모리에서 시작해도 그 상태가 유지되지 않아요. GPT-5.4로 ALFWorld 메모리를 Static-Group으로 구성한 뒤 같은 trajectory pool을 GPT-5-nano로 계속 갱신하면 Qwen3.5-27B/9B/4B 세 solver 모두에서 효용이 내려가요.
이미 풀었던 문제를 다시 틀려요
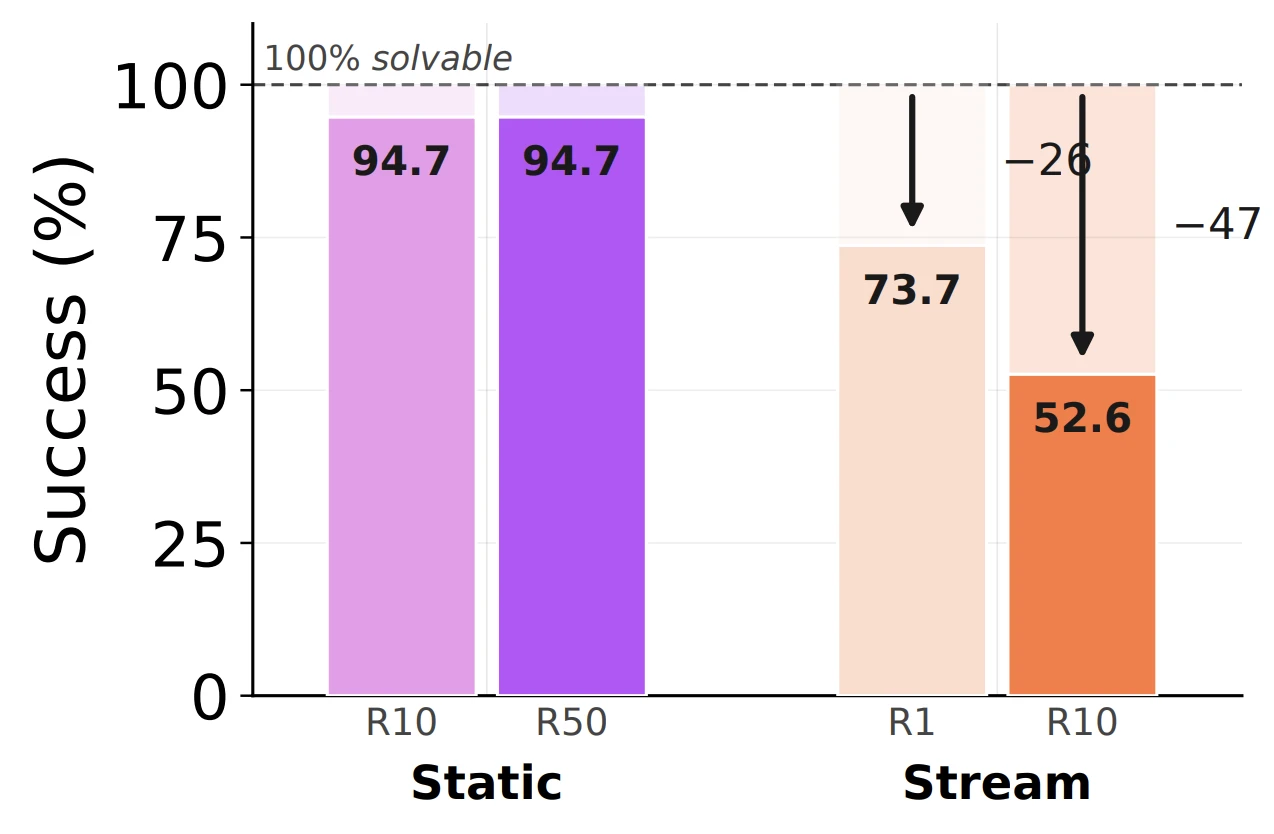
가장 명확한 증거예요. GPT-5.4가 memory 없이 100% 푸는 ARC-AGI 19문제를 고른 뒤, 그 문제들의 ground-truth solution을 consolidation loop에 순서대로 입력해요. 입력은 전부 정답이고 평가 문제도 이미 풀 수 있던 문제인데, Stream 조건에서 Round 10에 52.6%까지 떨어져요. 같은 pool을 한 번에 요약하는 Static 조건은 R=50까지 100%를 유지해요.
Sampling noise가 아니라는 검증도 있어요. 10회 반복했을 때 batched 70.0±7.8 대 streamed 55.8±7.1로 격차가 run 간 분산보다 커요. 19문제 slice에만 나타나는 현상도 아니어서, no-memory 정답률 50% 이상인 33문제로 확장해도 같은 결과가 나와요.
| ARC-AGI Stream (GPT-5.4, 10 runs) | pass@1 | pass@10 |
|---|---|---|
| No memory | 58.5 ± 5.4 | 100% (33/33) |
| Consolidated, epoch 1 | 55.1 ± 4.9 | 66.7% (22/33) |
| Consolidated, epoch 10 | 38.5 ± 5.3 | 60.6% (20/33) |
pass@10을 봐야 해요. Epoch 10에서 33문제 중 13개는 10번 시도해도 한 번도 못 풀어요. 평균 정답률이 내려간 게 아니라 coverage 자체가 사라졌어요.
같은 경험도 갱신 스케줄에 따라 다른 메모리가 돼요
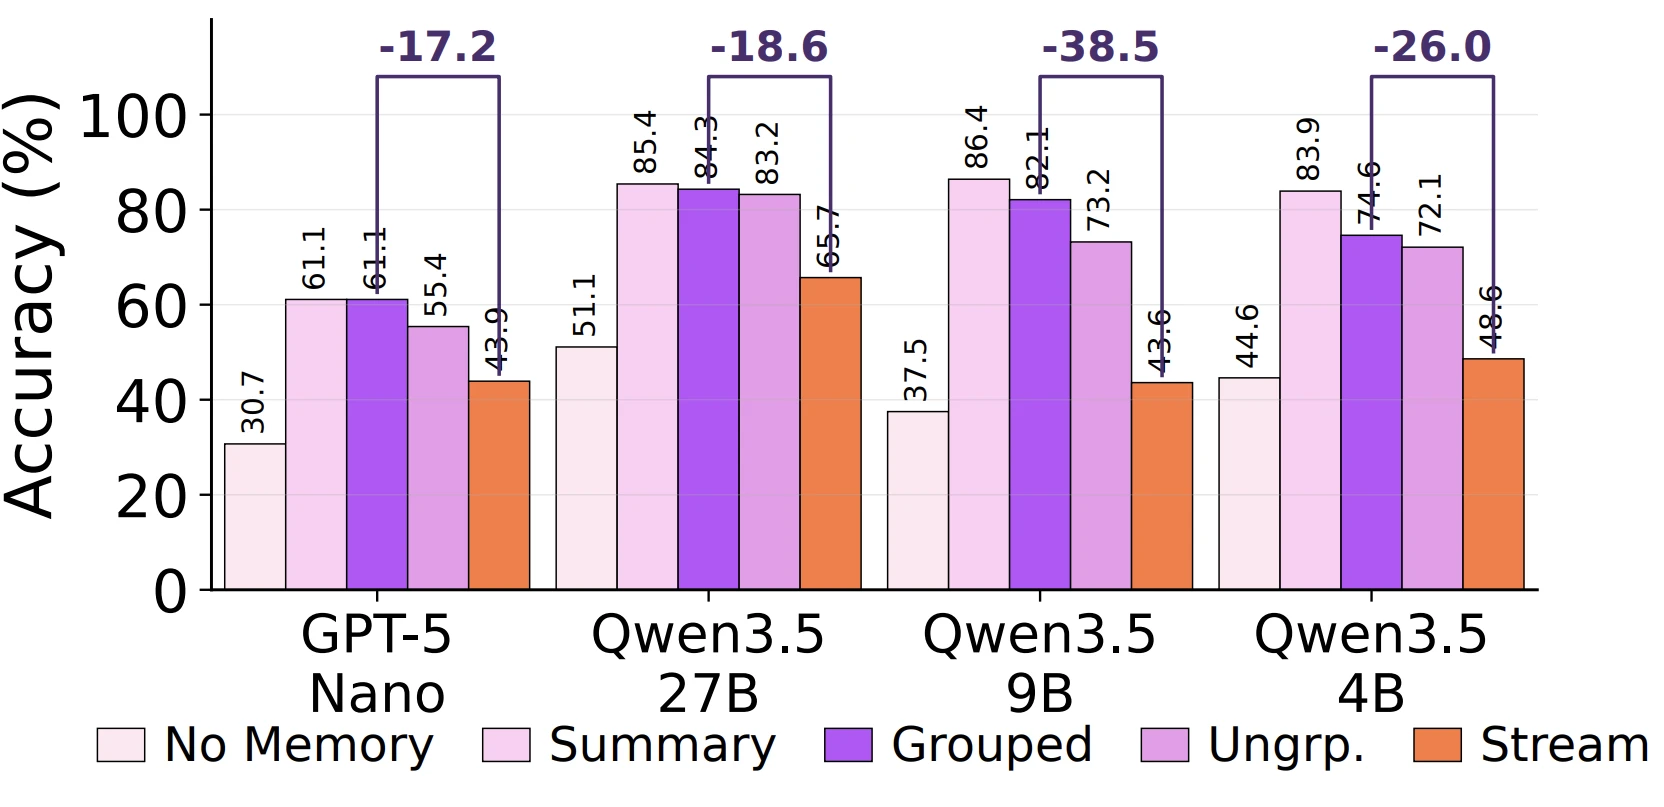
ALFWorld에서 trajectory pool을 고정한 채 제시 방식만 바꾸면 최대 38.5점까지 벌어져요. Qwen3.5-9B 기준으로 Static-Group이 82.1인데 Stream은 43.6이에요. 내용이 아니라 순서와 묶음만 바꿔서 나온 차이예요.
세 가지 규칙성이 나와요.
- Task family별로 묶어서 요약하는 쪽이 유리해요. Static-Group이 Static-All(Ungrp.)보다 일관되게 높아요. 이질적인 task를 한 abstraction step에 넣으면 관련 없는 절차끼리 섞여요.
- 한 번에 요약하는 쪽이 streaming보다 나아요. 같은 pool인데 Stream이 모든 backbone에서 최하위예요. 초기 abstraction이 이후 rewrite의 context로 들어가면서 작은 오류가 누적된다는 해석이에요.
- Streaming 안에서도 heterogeneous batch가 더 빨리 나빠져요. Batch 안에 여러 task를 섞으면 한 번의 update에서 양립 불가능한 lesson이 병합돼요.
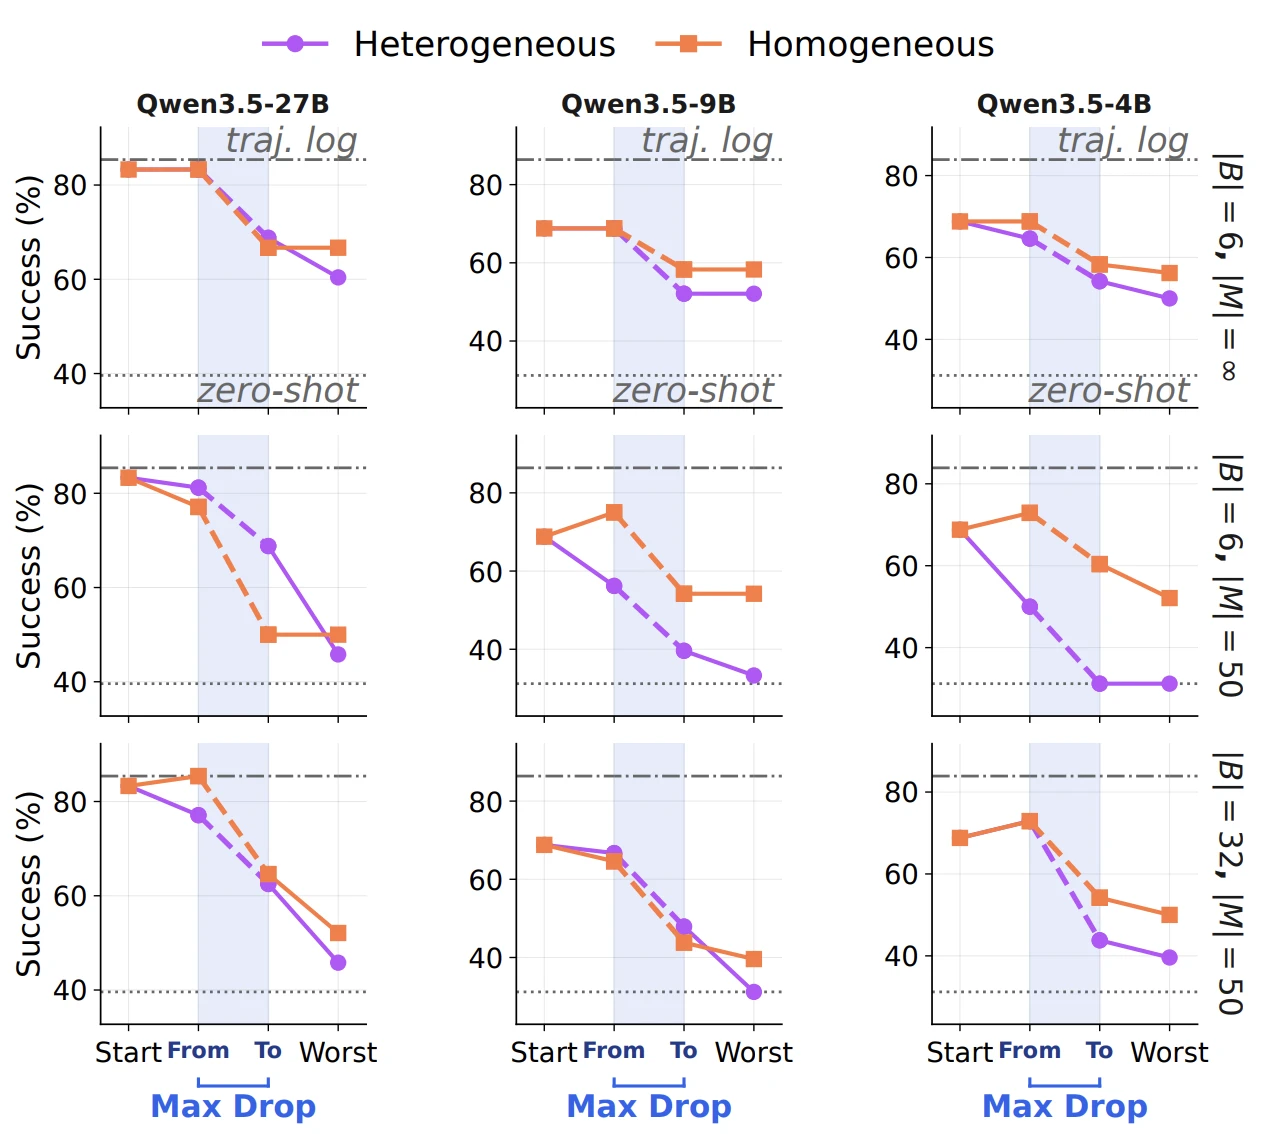
세 번째 항목은 Fig 4에서 확인할 수 있어요. Solver 세 개와 batch/memory 설정 세 개를 교차해 시작점부터 최저점까지의 낙폭을 그린 건데, 같은 설정에서 heterogeneous batch의 낙폭이 homogeneous batch보다 커요.
문제는 실제 continual learning loop가 전체 pool을 볼 수 없다는 점이에요. 경험이 쌓이는 대로 갱신해야 하니 구조적으로 가장 불리한 regime에 놓여요.
Raw trajectory가 이미 강한 baseline이에요
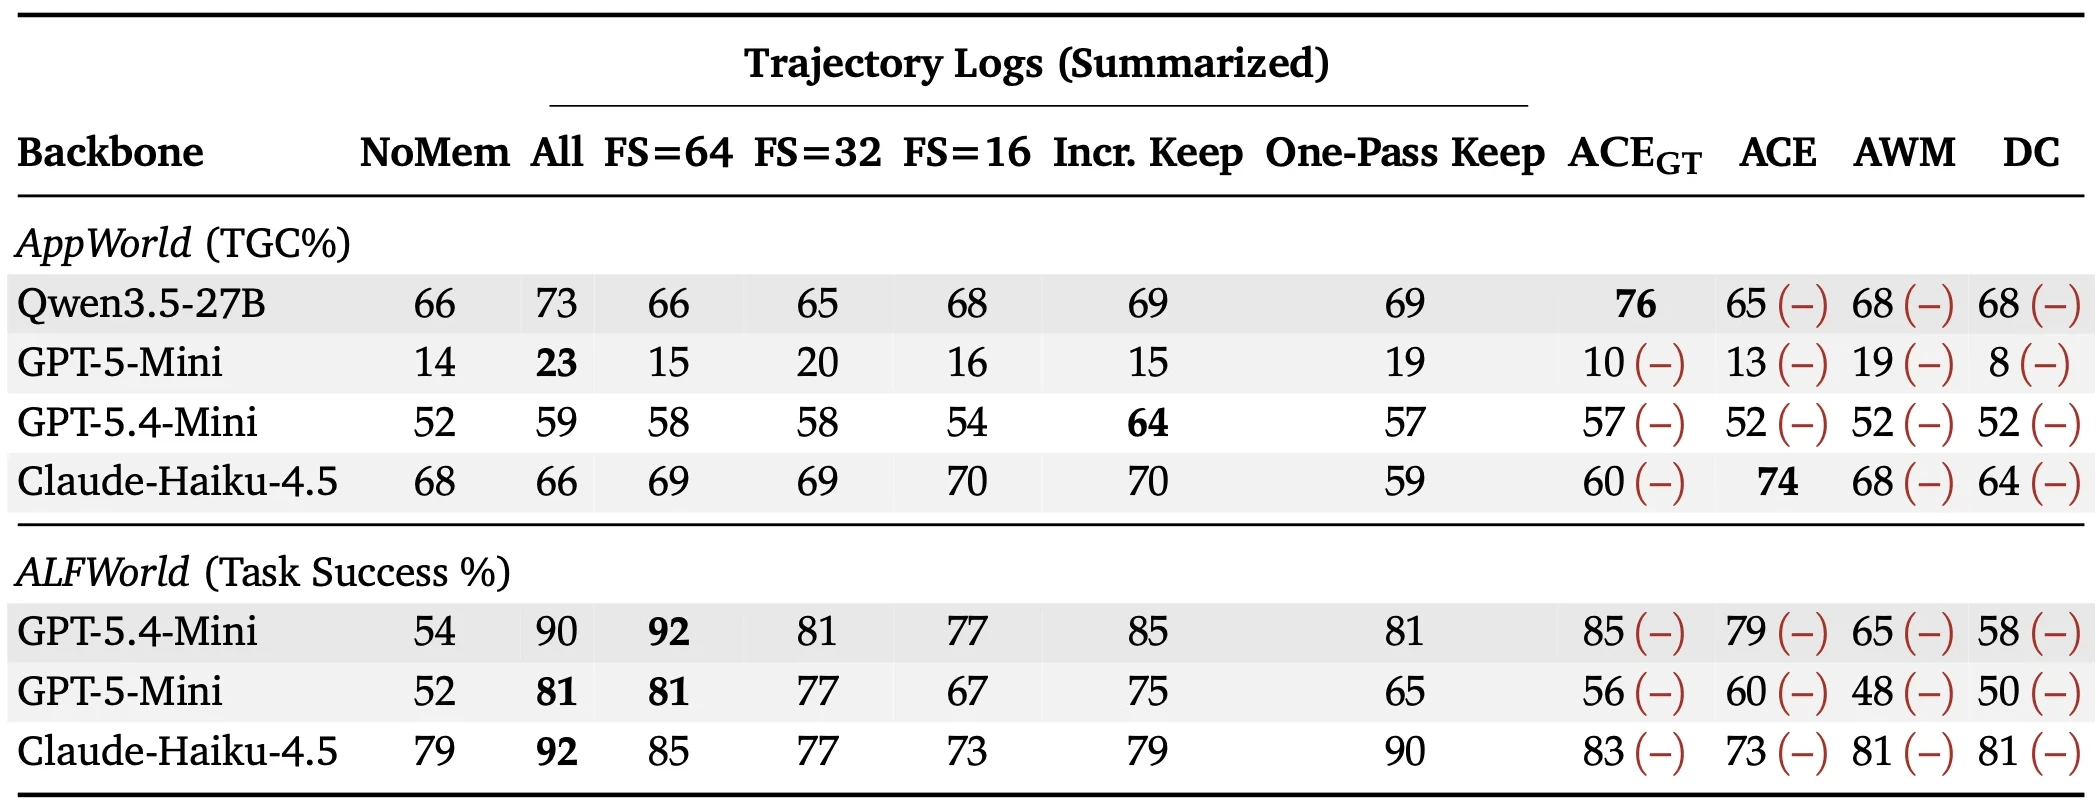
논문이 제안하는 진단용 대조군은 episodic-only 메모리예요. Cross-trajectory abstraction 없이 rollout을 그대로 append해서 context에 넣는 방식이고, consolidator가 요약해야 할 바로 그 경험을 저장해요.
AppWorld와 ALFWorld 모두에서 ACE/AWM/Dynamic Cheatsheet 같은 lesson-style 방법은 raw trajectory log baseline에 밀리거나 비슷한 수준에 그쳐요. ALFWorld GPT-5.4-Mini 기준으로 trajectory log “All”이 90인데 ACE 85, AWM 79, DC 65예요. 4회 반복해 분산을 붙인 결과에서도 순서는 같아요(All 91.07±1.02 대 DC 57.14±6.12).
해석은 두 가지예요. 첫째, abstraction 이전의 증거에 solver가 직접 쓸 수 있는 신호가 이미 들어 있어요. 관찰, 행동, 중간 실패, 환경 피드백이 구체적 상황에 묶인 채로 남아 있기 때문이에요. 둘째, distillation으로 가치를 주장하는 메모리 방법은 자신이 요약한 원본 rollout과 반드시 비교되어야 해요. 기존 agentic memory 논문들이 대체로 빠뜨린 비교예요.
백본과 프레임워크를 바꿔도 같은 곡선이 나와요
LangMem, Mem0, ProPlay, ACE, AWM, Letta, Dynamic Cheatsheet 7개 프레임워크를 GPT-5.4-mini와 Claude Sonnet 5 두 backbone으로 AppWorld/WebShop/ScienceWorld에서 돌리면, 모든 프레임워크가 최소 한 설정에서 peak 대비 하락해요. ACE는 AppWorld에서 50점이 빠져요.
메모리 관리 권한을 frontier agent에게 넘겨도 마찬가지예요. OpenCode harness에 각 모델의 최대 reasoning budget을 주고 메모리를 자유롭게 조회/수정/삭제하게 해도 곡선 형태가 같아요.
| Backbone | No memory | Peak | Step 400 | Peak → 400 |
|---|---|---|---|---|
| GPT-5.5 | 78.0 | 80.0 | 68.0 | −12.0 |
| Claude Sonnet 5 | 40.0 | 58.0 | 48.0 | −10.0 |
| GLM 5.2 | 22.0 | 44.0 | 22.0 | −22.0 |
| DeepSeek V4 Pro | 28.0 | 40.0 | 18.0 | −22.0 |
네 backbone 모두 no-memory 위로 올라갔다가 peak에 도달한 뒤 내려와요. GLM 5.2는 no-memory 수준으로 돌아오고 DeepSeek V4 Pro는 그 아래로 떨어져요. 모델 능력은 peak의 위치를 옮길 뿐 하락 자체를 없애지 못해요.
Context length도 prompt optimization도 원인이 아니에요
대안 설명 두 가지를 논문이 직접 검증해요.
Context rot 가설. ARC-AGI Stream prompt에 랜덤 training 문제를 padding으로 넣어 context만 길게 만들어요. 해답 없이 채운 경우(약 790K token)와 해답까지 채운 경우(약 733K token) 모두 정확도 하락이 2점대이고 통계적으로 유의하지 않아요. Consolidation이 일으키는 하락과는 규모가 달라요.
Prompt 가설. Static과 Stream은 같은 solver/consolidation prompt를 쓰는데도 18/19 대 10/19로 갈려요. 추가로 붕괴된 epoch 10 상태에 GEPA prompt optimization을 적용하면 47.9에서 66.3으로 일부 회복하는데, 회복 방식이 solver에게 메모리를 신뢰하지 말라고 지시하는 형태예요. 메모리를 고친 게 아니라 무시하게 만든 결과예요.
Update의 어느 부분이 손상을 일으키나
Streamed update가 나빠질 수 있는 경로는 셋으로 분리돼요. (1) initial compression error는 batch를 처음 요약할 때 잃는 정보, (2) cross-update conditioning은 앞선 불완전한 abstraction이 context로 들어가 다음 요약을 편향시키는 효과, (3) destructive rewriting은 기존 entry를 in-place로 고치면서 누적되는 침식이에요.
같은 batch를 같은 순서로 입력하면서 update step이 볼 수 있는 것과 할 수 있는 것만 제한해 분리해요.
| Streaming variant | 제거한 것 | Accuracy |
|---|---|---|
| Default consolidation (in-place rewrite) | — | 43.2 |
| Append-only, prior store visible (A) | in-place rewriting | 50.0 |
| Add + delete, no in-place edit (C) | in-place rewriting (pruning 유지) | 64.0 |
| Append-only, prior store hidden (B) | rewriting + conditioning | 70.0 |
| Raw trajectories | 모든 consolidation | 76.6 |
- 단일 요소로는 in-place rewriting이 가장 해로워요. 이것만 금지해도 43.2에서 50.0으로 오르고, 삭제를 허용한 C는 64.0까지 올라가요.
- Pruning은 오히려 도움이 돼요. C와 A의 차이는 삭제 허용뿐이에요. 손상은 메모리를 줄이는 동작이 아니라 덮어쓰는 동작에서 나와요.
- Conditioning의 부호는 갱신 빈도에 따라 달라져요. Batch size 1에서는 이전 store를 숨기는 쪽이 유리하지만(50.0 → 70.0), batch size 8에서는 반대로 뒤집혀요. 400번 갱신하면 편향 누적 비용이 이득을 넘어서요.
- 가장 통제된 조건도 raw trajectory에 못 미쳐요. B(batch 1)의 70.0도 raw code trajectory 76.6보다 낮아요. 이전 메모리도 없고 rewrite도 없는 상태에서 남은 격차는 첫 요약에서 이미 정보를 잃었다는 뜻이에요.
B는 진단용이지 배포 가능한 설정이 아니에요. 중복 제거를 못 해서 entry가 4.83배, 텍스트가 3.81배로 늘고 결국 context window를 넘겨요.
Batch를 키우면(8 → 32) terminal success가 올라가고, autonomous mode에서 모델이 자발적으로 consolidate하는 비율도 18.5%에서 46%로 늘어요. 묶음이 넓어지면 task type 구분이 정확해지기 때문인데, raw 경험을 유지하는 것과의 격차는 그래도 닫히지 않아요.
Episodic store를 남기면 회복돼요
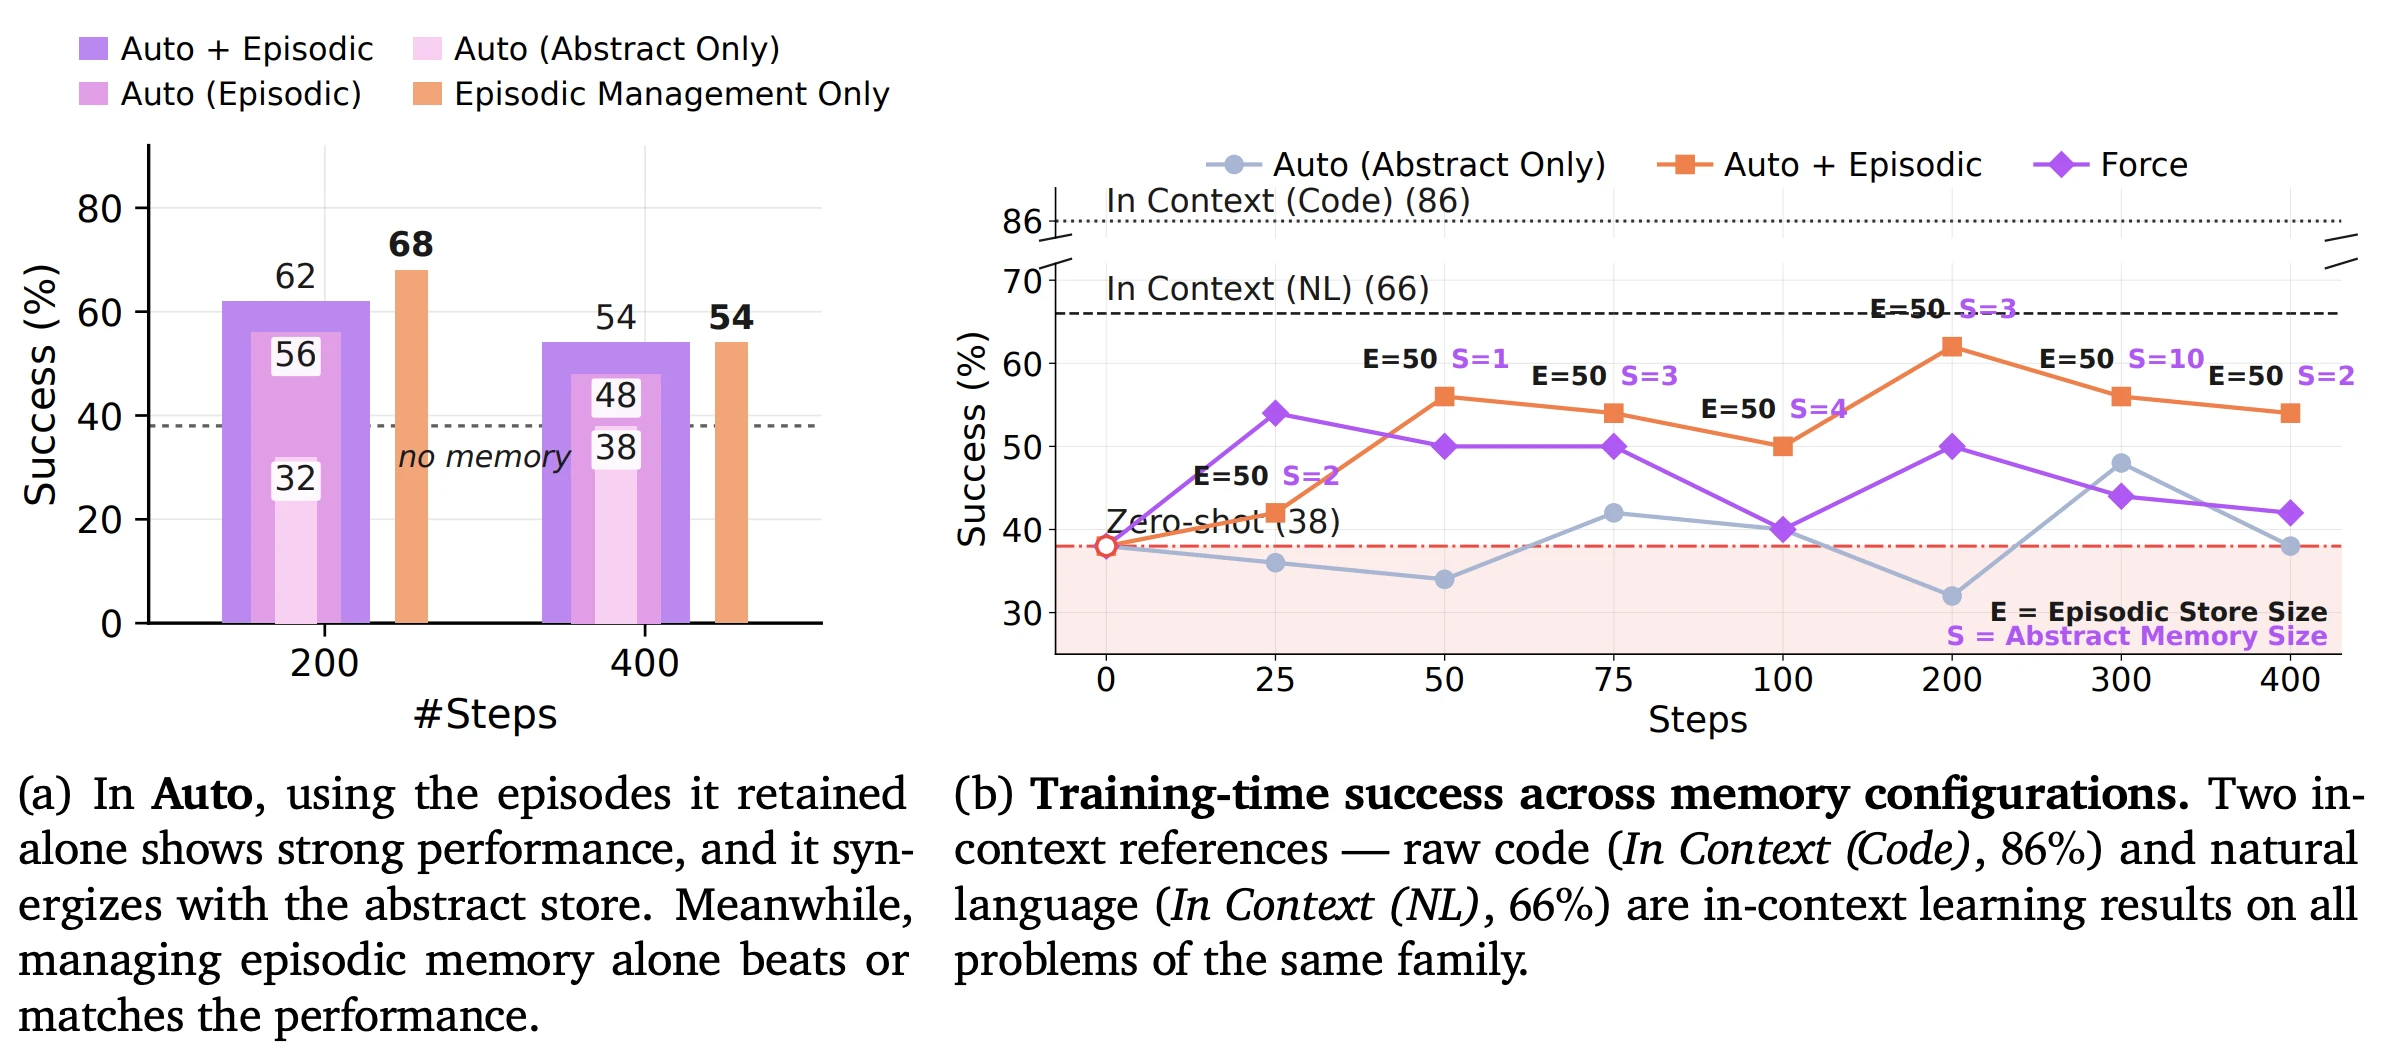
ARC-AGI Stream에서 episodic과 abstract를 분리해 두고 세 제어 조건을 비교해요.
- 이득의 대부분이 episodic store에서 나와요. Abstract만 읽게 하면 정확도가 no-memory baseline(38)까지 떨어져요. Episodic Only는 48~56 구간이고 둘을 합친 Auto는 54~62예요. 쓸모 있는 정보는 요약본이 아니라 원본 episode에 남아 있었어요.
- Abstraction을 꺼도 손해가 없어요. Retain/delete만 허용하는 Episodic Management Only가 step 200에서 68, step 400에서 54로 full Auto와 같거나 더 높아요.
- 강제 abstraction이 가장 나빠요. 400 step 동안 Auto가 Force를 두 backbone 모두에서 앞서요. 압축으로 얻는 것보다 증거를 덮어쓰면서 잃는 것이 더 커요.
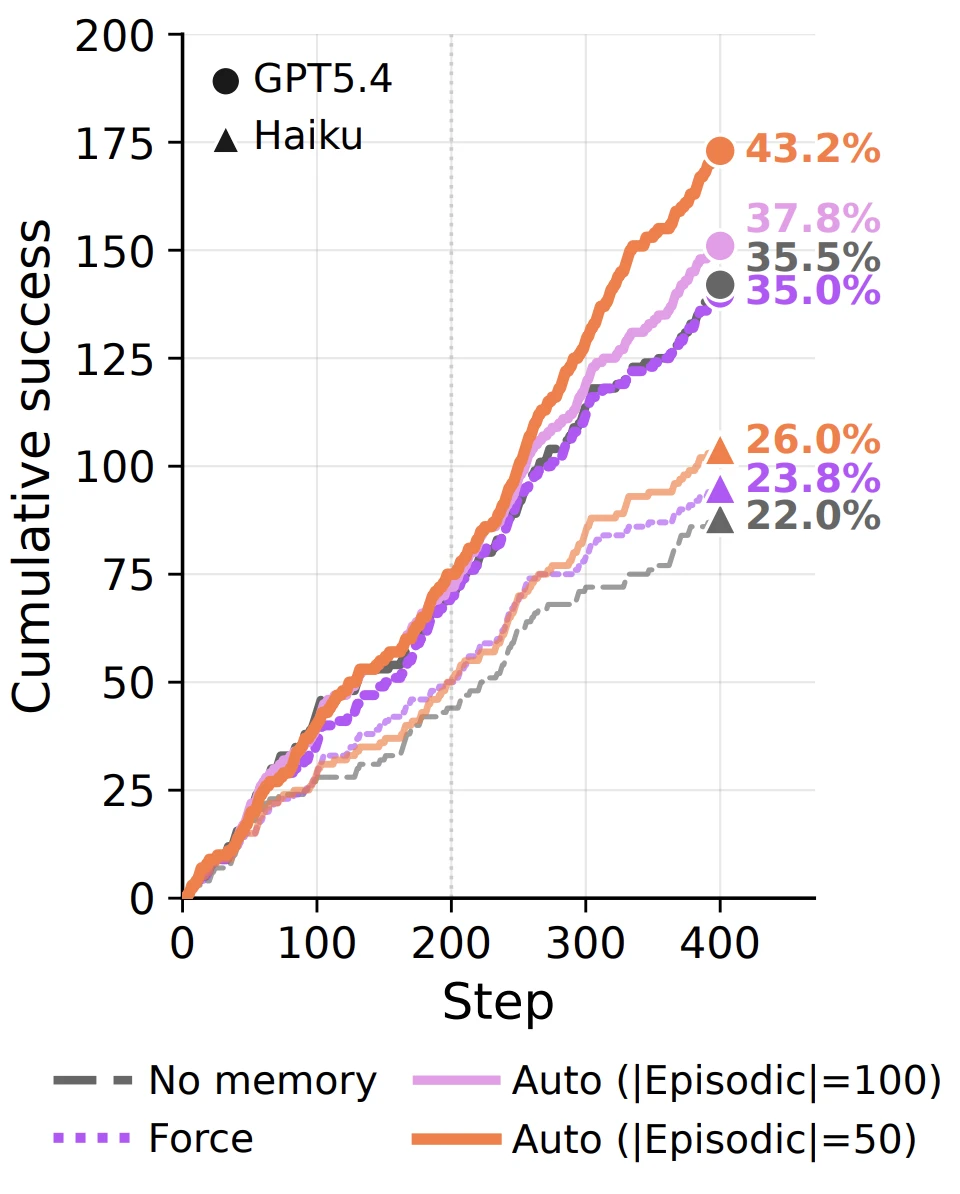
400 step 누적 성공률로 보면 GPT-5.4에서 Auto(|Episodic|=50)가 43.2%, Auto(|Episodic|=100)가 37.8%인데 Force는 35.5%로 no-memory(35.0%)와 거의 같아요. Haiku도 26.0% / 23.8% / 22.0%로 순서가 같아요. 매 step 요약을 강제하면 메모리를 붙인 이득이 거의 남지 않아요.
에이전트 자신의 선택도 같은 방향이에요. 선택권을 주면 episodic buffer를 빠르게 채우고 abstract store는 적게 유지해요(E=50일 때 S=1~4). Buffer cap을 50에서 100으로 키우면 Compress 행동 비율이 18.5%에서 9.0%로 줄고 Keep이 20.8%에서 32.5%로 늘어요.
참고 상한선도 의미가 있어요. 같은 family 문제를 전부 in-context로 넣었을 때 raw code가 86%, 자연어 설명이 66%인데, 어떤 consolidation 설정도 62%를 넘지 못해요.
Abstraction은 세 가지 방식으로 실패해요
Misgrouping. Abstraction 전에 어떤 경험끼리 묶을지 정해야 하는데, 이 segmentation이 자주 틀려요. Segmentation 능력 자체는 있어요. 자율권을 주면 모델은 결국 6개 문제 유형을 모두 포함하는 episodic store로 수렴해요. 다만 71 step(568 examples)이 걸려요. Force regime에서는 매 step 8개 예제로 요약을 강제하니, 서로 다른 class의 episode를 합치는 misclassification이 계속 누적돼요. 병목은 class 구조를 인식하는 능력이 아니라 강제된 abstraction이 그 구조를 덮어쓴다는 점이에요.
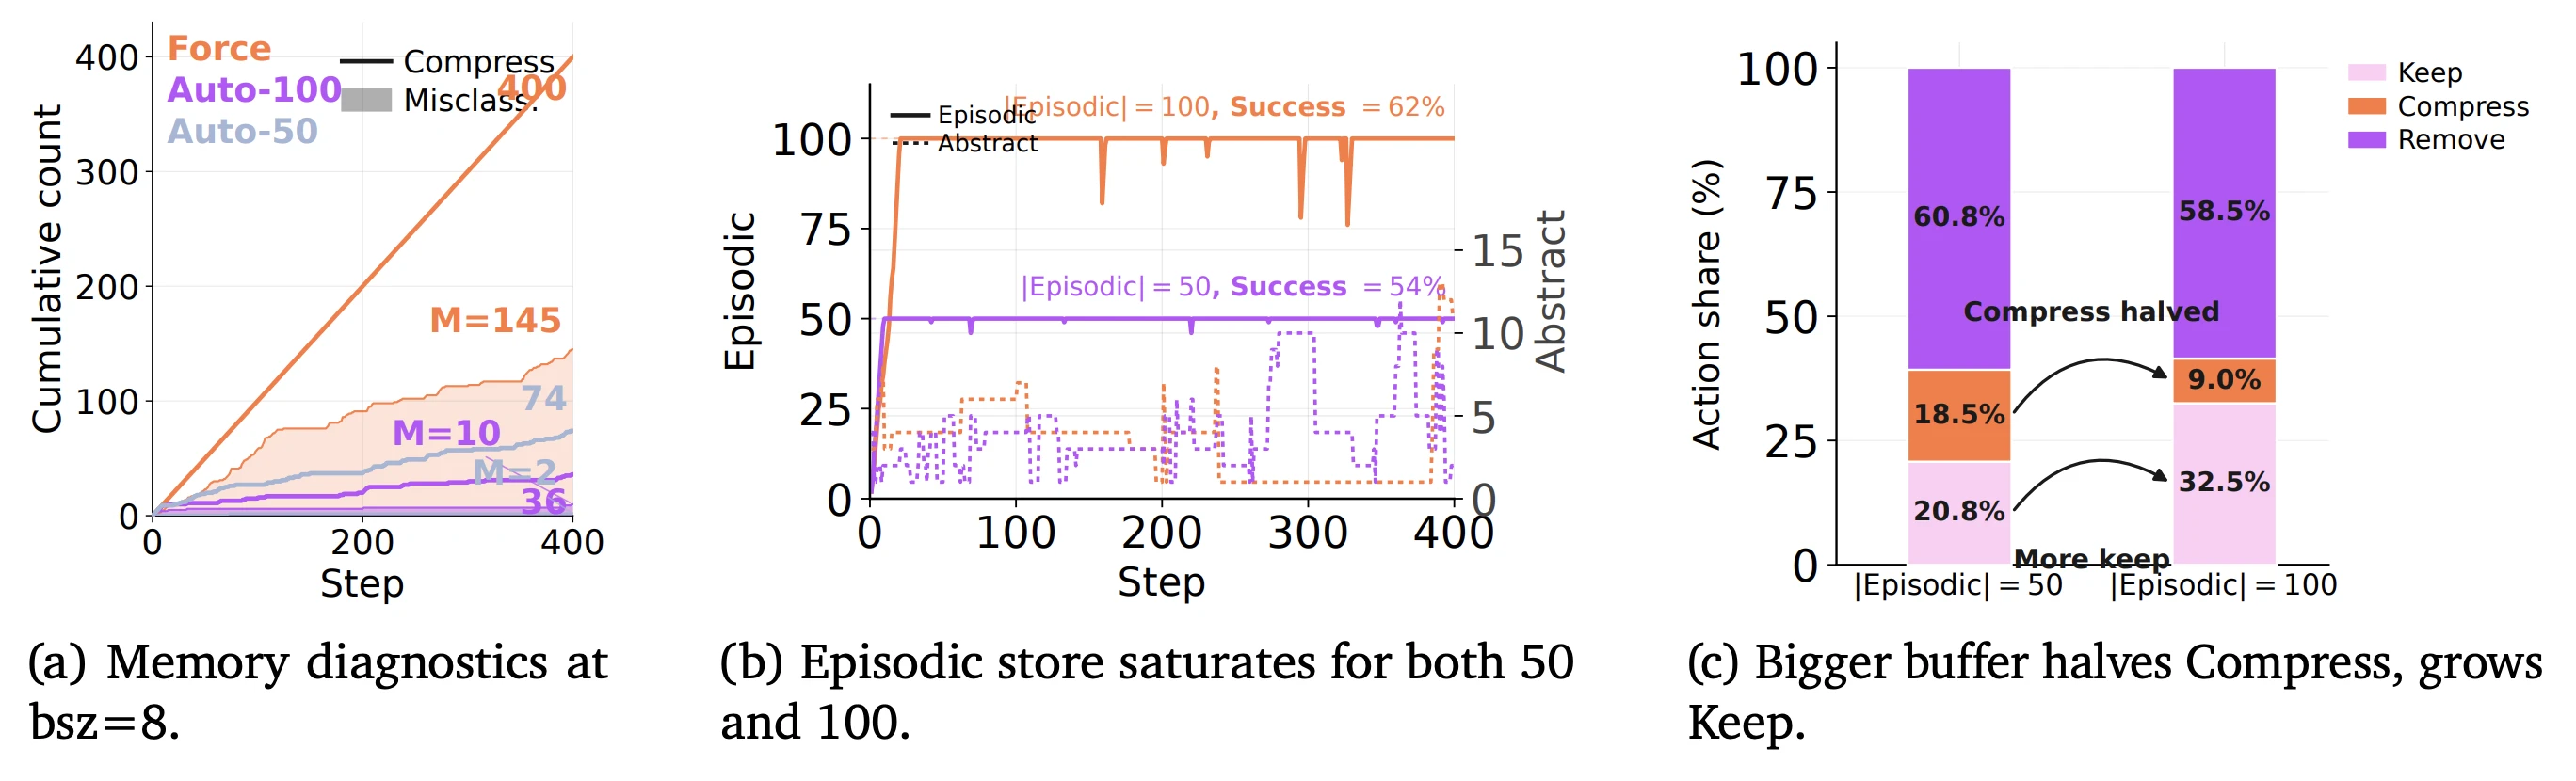
Fig 7a의 misclassification count는 두 개 이상의 problem class를 한 번에 묶은 memory 동작의 누적 횟수예요. Force에서는 400 step 동안 400건 가까이 직선으로 증가하는 반면, Auto-50은 36건, Auto-100은 74건에 그쳐요. Fig 7b는 Auto가 episodic buffer를 cap까지 빠르게 채운 뒤 유지한다는 걸 보여주고, Fig 7c는 앞 절에서 인용한 Compress/Keep 비율 변화예요.
Interference. 요약을 반복하면 lesson의 적용 조건이 사라져요. ALFWorld에서 Pick&Place에 대해 distillation을 반복할수록 인접한 Pick-Clean-Place 정확도가 떨어져요(Qwen3.5-27B 기준 70.4% → 22.2%).
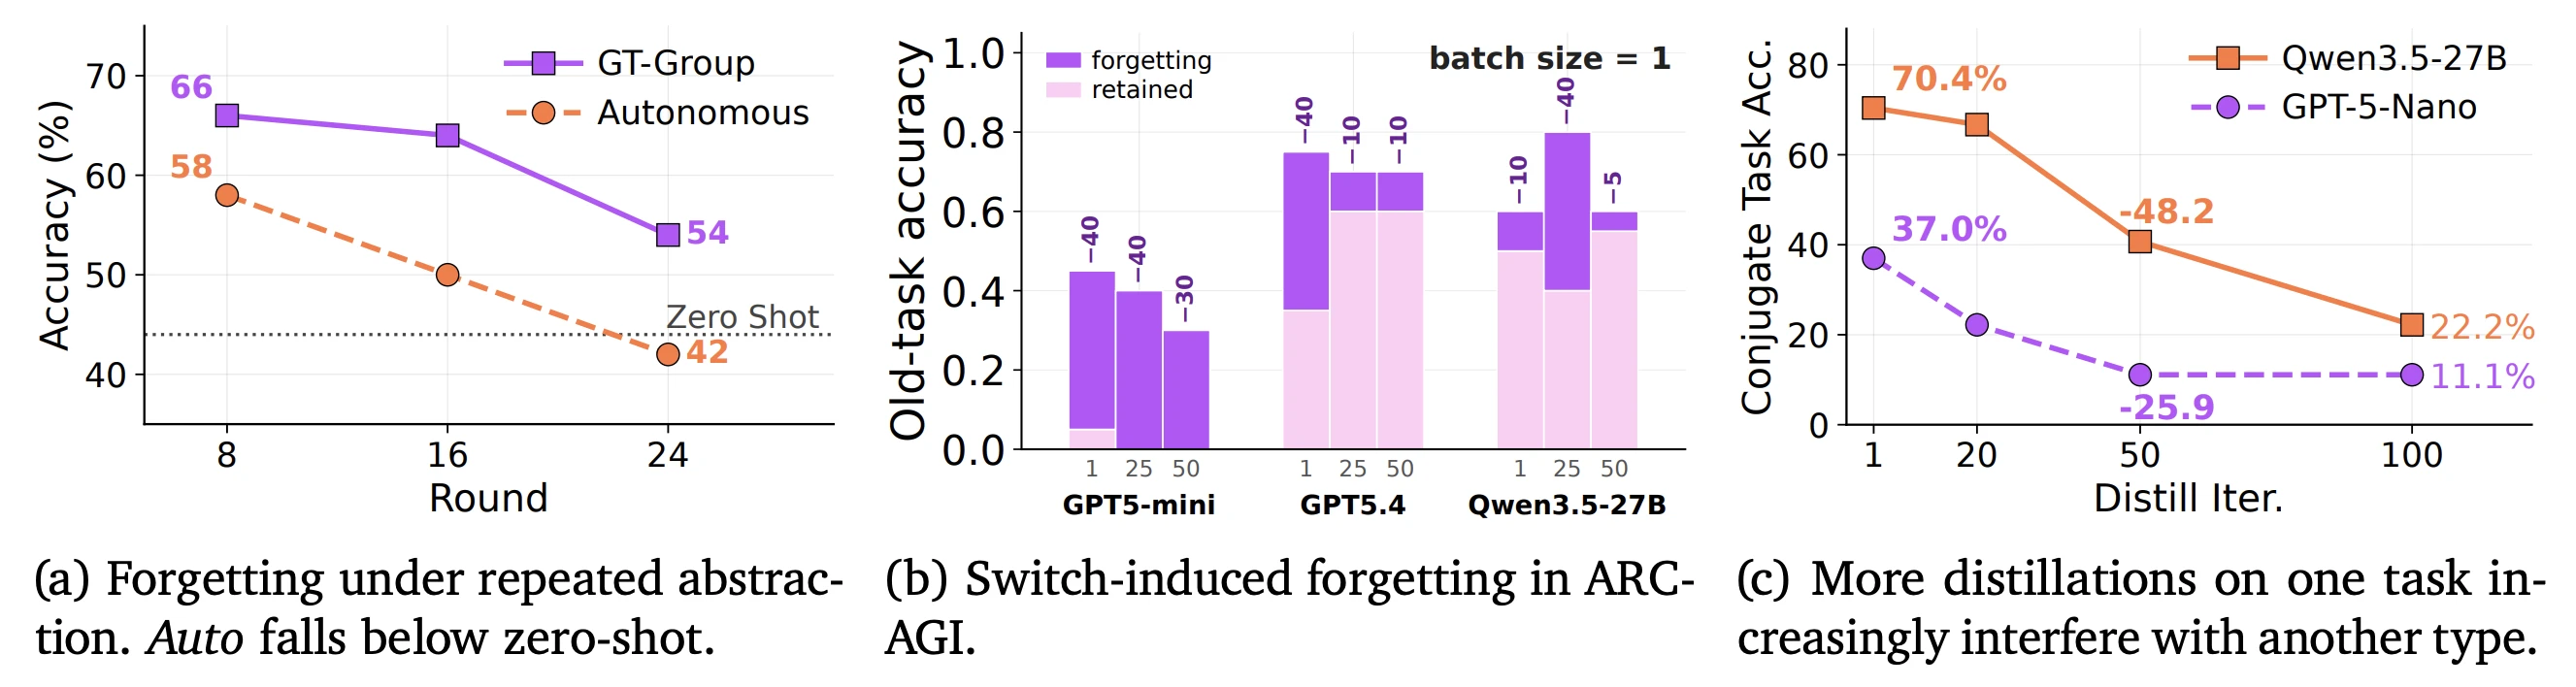
Fig 8은 같은 현상을 세 각도에서 보여줘요. (a)는 같은 pool을 round마다 다시 요약할 때 GT-Group이 66에서 54로, Autonomous가 58에서 42로 내려가 zero-shot 아래까지 간다는 걸 보여줘요. (b)는 ARC-AGI에서 task를 한 번 바꾸는 것만으로 이전 task 정확도의 상당 부분이 사라진다는 걸 보여주고, (c)가 위에서 인용한 ALFWorld conjugate task 결과예요.
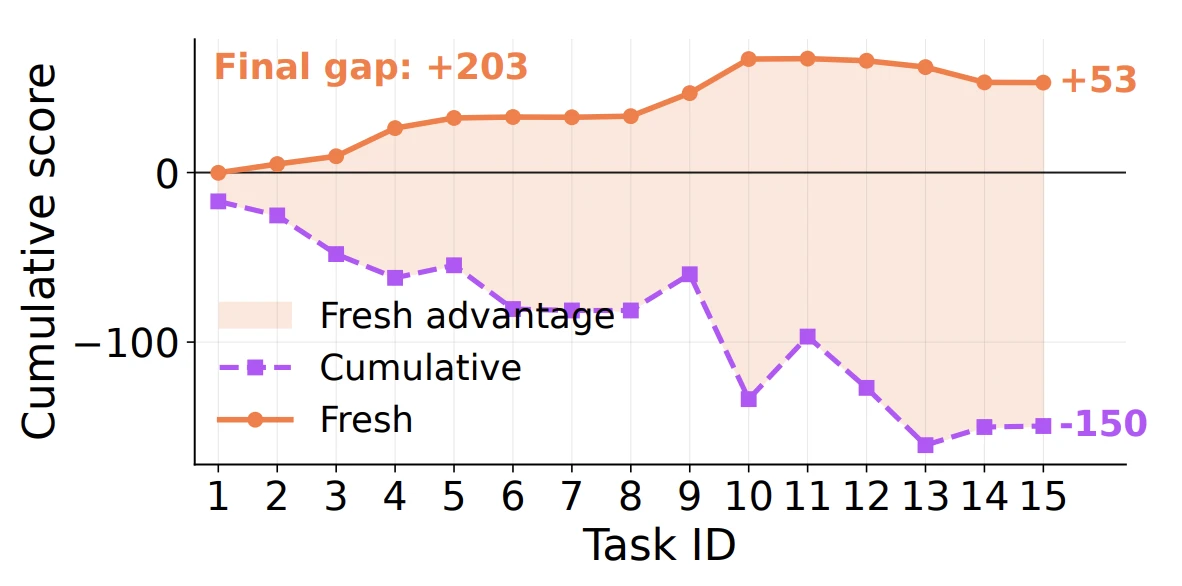
ScienceWorld 15-task switch sequence에서는 매 task마다 새로 요약하는 Fresh와 1..t를 누적 요약하는 Cumulative를 비교해요. Cumulative는 task 3 근처부터 벌어지기 시작해 최종 203점 뒤처져요. LLM judge로 entry를 분류하면 Cumulative가 over-generalized 메모리를 약 5배, garbage 메모리를 약 20배 더 쌓고 그 격차가 단조 증가해요.
Overfit. 입력 분포가 좁아지면 반대 방향으로 실패해요. 같은 strategy family 문제만 반복 입력하면 요약이 문제 해결 전략이 아니라 관찰된 인스턴스의 표면 규칙성으로 수렴해요.
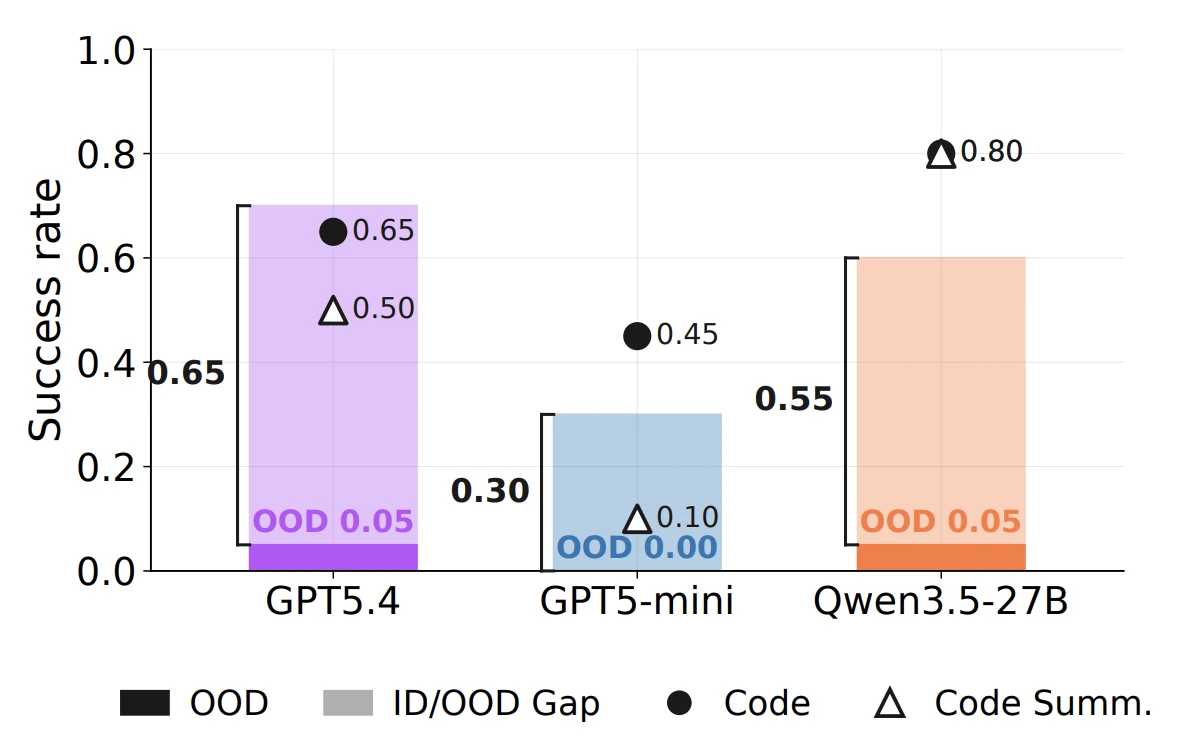
압축에 쓰인 문제는 풀지만 같은 family의 간단한 변형에서 실패해요. GPT-5.4는 ID 0.65 대 OOD 0.05, Qwen3.5-27B는 ID 0.80 대 OOD 0.05예요.
세 mechanism은 공통적으로 무엇을 일반화하고, 무엇을 task-specific으로 남기고, 무엇을 raw episode로 보존할지의 구분을 흐려요.
메모리 한 항목이 정책을 망가뜨리는 사례가 있어요
효용 곡선 말고 content 수준의 증거도 있어요. WebShop에서 AWM 1 epoch consolidation으로 나온 workflow 파일은 W1~W8 여덟 항목을 담고 있는데, 여기서 W8 하나만 빼고 나머지는 그대로 두고 재평가해요.
| Rollout | Memory | wins/50 | mean reward | mean steps |
|---|---|---|---|---|
| gpt-5.4-mini | full (8 workflows) | 7 | 0.23 | 12.4 |
| gpt-5.4-mini | minus W8 (7) | 14 | 0.37 | 11.4 |
| gpt-5-mini | full (8 workflows) | 18 | 0.49 | 18.2 |
| gpt-5-mini | minus W8 (7) | 23 | 0.59 | 15.8 |
W8은 “첫 페이지에 맞는 결과가 없으면 다음 페이지로 넘어가라”는 workflow예요. 문제가 세 가지예요. 중단 조건이 정의되어 있지 않아 언제 멈출지 알 수 없고, 다른 workflow에는 있는 “가장 잘 맞는 결과를 연다”는 선택 단계가 빠져서 후보 placeholder가 실제 상품에 연결되지 않고, click[Next >]라는 저수준 navigation 동작이 독립 workflow로 올라가면서 페이지만 넘기는 행동이 정당한 전략처럼 읽혀요.
행동 통계도 같은 방향이에요. W8이 있으면 click[Next >] 호출이 두 rollout 모두에서 2.3배 많고, click[Buy Now]를 한 번이라도 낸 episode 수는 14/50에서 21/50으로 늘어요. 요약이 만들어낸 한 항목이 dead loop를 유도했어요.
Catastrophic forgetting과는 다른 현상이에요
네 지점에서 갈려요.
- Task 분포가 고정된 상태에서 발생해요. 새 domain이 들어오지 않았는데도 이미 풀 수 있던 문제의 약 46%가 풀리지 않게 돼요. Catastrophic forgetting은 이 현상을 예측하지 않아요.
- Interleaving이 오히려 해로워요. Catastrophic forgetting 문헌에서는 task를 섞으면 망각이 줄어드는데, 여기서는 heterogeneous batch가 더 나쁜 메모리를 만들어요.
- 같은 증거가 도착 순서에 따라 다른 결과를 내요. 원인이 증거의 내용이 아니라 반복되는 rewrite라는 뜻이에요.
- 손실이 아니라 왜곡이에요. 메모리를 직접 보면 병합된 task family, 범위를 벗어난 일반화, 확신에 찬 틀린 절차, 삭제된 예외 조건이 나와요. 옛 지식이 흐려지는 게 아니라 사실이 아닌 진술이 쌓여요.
처방도 달라요. Rehearsal이나 drift regularization이 아니라, abstraction을 gating하고 지연시키면서 episode를 보존하는 쪽이에요.
정리하면 raw episode를 일급 증거로 다뤄야 해요
논문의 결론은 architecture 수준의 제안이에요. Complementary Learning Systems 관점에서 빠른 episodic store와 느린 schema-forming store는 서로를 덮어쓰지 않도록 분리되어야 하고, consolidation은 매 event마다 발동하는 대신 schema fit에 따라 gating되어야 해요. 현재의 update-after-every-interaction 설계는 이 분리를 하나의 rewrite loop로 합치면서 dual-system 설계가 막으려던 interference 조건을 다시 만들어요.
읽으면서 눈에 띈 부분들이에요.
- 비교 기준이 가장 큰 기여로 보여요. “요약본이 원본 rollout을 이기는가”라는 대조군은 구현이 어렵지 않은데도 기존 agentic memory 논문들이 잘 쓰지 않았어요. Table 4는 여러 방법이 이 비교를 통과하지 못한다는 걸 보여줘요.
- 결론이 “abstraction은 나쁘다”는 아니에요. Force와 Auto의 비교, batch size를 키웠을 때의 회복은 문제가 abstraction 자체가 아니라 매 step 강제되는 rewrite라는 쪽을 가리켜요. 논문도 episodic 누적이 장기 해답은 아니라고 명시해요. 기록이 무한정 커지고 compositional reuse가 어렵기 때문이에요.
- Attribution 실험에는 닫히지 않는 격차가 남아요. In-place rewrite를 막고 conditioning을 없앤 조건도 raw trajectory에 못 미치는데, 첫 요약에서 이미 정보를 잃는다는 의미라 스케줄 조정만으로는 해결되지 않아요.
- 일반화 주장은 넓게 받쳐져 있어요. 7개 프레임워크, 5개 backbone, autonomous coding agent, 790K token context, prompt optimization까지 확인해서 단일 구현의 문제로 보기는 어려워요. 다만 ARC-AGI Stream이 논문 자체 testbed이고 가장 강한 수치가 거기서 나온다는 점은 감안할 필요가 있어요.
- 실무적으로는 gating이 먼저예요. 매 interaction마다 메모리를 갱신하는 대신 raw episode를 기본으로 보존하고 abstraction은 명시적 조건에서만 호출하는 구조가 지금 backbone 기준으로는 안전해요. 삭제는 허용하되 in-place 수정은 피하는 편이 나아요.