vLLM & Redis: 캐싱하면 빨라지긴 해요?
캐싱이 진짜 필요한 걸까요?
PagedAttention이 처음 나왔을 때부터 vLLM이 유용하다는 건 알고 있었어요. 다만 제가 LLM을 쓰는 곳은 주로 동시 접속이 없는 연구실 환경이라 필요성을 크게 느끼지 못했어요. 써 보려고 해도 오래된 서버에서는 CUDA 버전이 맞지 않아 오류가 나거나, 필요한 모델을 지원하지 않아 쓸 수 없었어요. 그러다 문득 궁금해졌어요. vLLM을 쓰면 얼마나 빨라지길래 다들 vLLM으로 서빙하는 걸까요? 그래서 Transformers + FastAPI로 직접 만든 서버와 vLLM으로 서빙하는 서버를 각각 준비하고, k6로 사용자 수를 늘려 가며 처리량과 속도를 측정했어요.
vLLM을 측정하는 김에 Redis의 성능도 확인해 봤어요. Redis는 늘 봐 왔지만, 앞서 말한 이유로 빠른 서빙이 필요 없어서 그동안은 메모리에 직접 읽고 쓰는 방식으로 로직을 짰어요. 그런데 Redis를 적용하면 얼마나 빨라지길래 다들 거의 필수로 쓰는지 궁금했어요.
실험 세팅
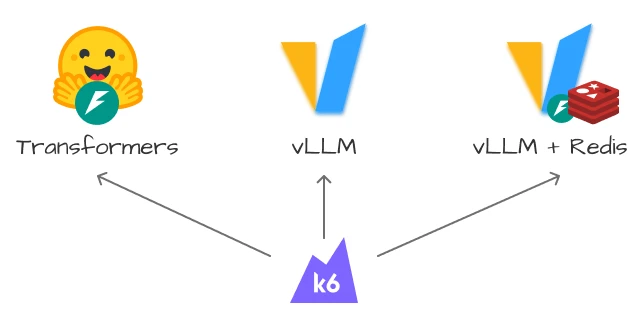
실험에는 RTX 4060(VRAM 8GB) 한 장과 RAM 32GB를 갖춘 WSL2 Ubuntu 환경을 사용했어요. 이 사양에 맞춰 작은 모델인 Qwen3-0.6B(bf16, w/o thinking)를 골랐어요. vLLM은 실험 날짜 기준 최신 stable release인 0.31.0을 사용했어요.
// 코드 일부 생략
const n = Math.floor(Math.random() * +__ENV.PROMPTS);
const res = http.post(
  `${__ENV.TARGET}/v1/chat/completions`,
  JSON.stringify({
    model: __ENV.MODEL,
    messages: [
      {
        role: "user",
        content: `Write a short story about the number ${n}.`
      },
    ],
  }),
);
세부 옵션은 생략했지만, 대략 이런 요청을 보냈어요. 숫자 하나를 주고 그 숫자에 대한 짧은 이야기를 쓰게 했고, max_token은 128로 제한했어요. 프롬프트는 마지막 숫자만 다르고 나머지는 모두 같아요. 그래서 캐시 적중률(hit rate)이 매우 높은 환경이에요.
이후 k6로 VUs(Virtual Users, 가상 사용자 수)를 늘려 가며 60초 동안 요청을 반복해서 보내고, 처리량과 지연 시간 등을 측정했어요.
vLLM이 약 400배 더 빨라요
| VUs | 서버 | 처리량 (tok/s) | 요청/s | 평균 지연 | p95 지연 |
|---|---|---|---|---|---|
| 1 | Transformers | 27.0 | 0.21 | 4.73s | 6.51s |
| 1 | vLLM | 139.0 | 1.09 | 0.92s | 0.96s |
| 8 | Transformers | 25.6 | 0.20 | 31.08s | 43.39s |
| 8 | vLLM | 1,045 | 8.17 | 0.98s | 1.05s |
| 32 | Transformers | 19.9 | 0.16 | 46.89s | 1m21s |
| 32 | vLLM | 3,463 | 27.05 | 1.18s | 1.25s |
유저가 1명일 때도 vLLM의 처리량은 Transformers + FastAPI보다 5배 많았어요. LLM은 auto-regressive 방식, 즉 앞서 만든 토큰을 바탕으로 다음 토큰을 하나씩 출력해요. 이때 GPU 연산뿐 아니라, CPU가 CUDA 커널을 준비하고 실행을 요청하는 과정에서도 오버헤드가 생겨요. vLLM에서는 CUDA Graph로 반복되는 GPU 작업을 캡처해 CPU 쪽 오버헤드를 줄여요.
VUs가 1에서 32로 늘었을 때, Transformers의 평균 지연은 4.73s에서 46.89s로 10배 가까이 늘었어요. 반면 vLLM은 0.92s에서 1.18s로 1.2배 늘어나는 데 그쳤어요. 처리량이 약 25배 늘어나는 동안 지연 시간은 1.2배만 늘어난 셈이에요. vLLM에는 continuous batching이 적용돼 있어요. 전통적인 static batching에서는 배치 안의 모든 요청이 끝나야 다음 배치를 처리해요. 그래서 중간에 먼저 끝난 요청이 생기면 그만큼 GPU 자원이 놀게 돼요. 반면 continuous batching에서는 배치 안에서 연산이 끝난 요청이 생기면 바로 다음 요청을 이어서 처리하도록 스케줄링해요. 다시 말해, 주어진 GPU 자원을 최대한 활용할 수 있어요.
여기에 더해 vLLM에서는 PagedAttention 기반의 KV cache를 활용해요. 그래서 prefill 단계(프롬프트 전체를 처음 처리하는 단계)에서 중복되는 프롬프트 영역을 재사용했을 거예요. 이처럼 GPU 단에서 일어나는 일이 vLLM 안에서 모두 최적화되다 보니, 동시 사용자가 많은 프로덕션 환경에서는 vLLM을 쓰는 편이 유의미하게 효율적일 것 같아요.
vLLM + Redis 조합으로 성능이 100배 높아져요
@app.post("/v1/chat/completions")
async def chat(req: Request):
    body = await req.body()

    # redis 조회
    key = hashlib.sha256(body).hexdigest()
    if hit := await redis.get(key):
        return Response(hit, media_type="application/json")

    # (cache가 없을 때) vLLM 요청
    resp = await vllm.post(
        "/v1/chat/completions",
        content=body,
        headers={"content-type": "application/json"},
    )

    if resp.status_code == 200:
        await redis.set(key, resp.content)
    return Response(resp.content, resp.status_code, media_type="application/json")
vLLM 요청을 FastAPI로 한 번 감싸고, 요청 단위로 Redis 캐싱을 적용했어요. 캐시가 있으면 vLLM을 호출하지 않고 바로 답변을 반환해요. 캐시에 없는 요청만 vLLM을 호출한 뒤, 그 결과를 Redis에 저장해요.
| PROMPTS | 구성 | 요청/s | 평균 지연 | p95 지연 | 최대 지연 |
|---|---|---|---|---|---|
| 50 | vLLM 직접 | 27.4 | 1.16s | 1.20s | 1.42s |
| 50 | vLLM + Redis | 2,811 | 11.3ms | 14.4ms | 1.43s |
| 1000 | vLLM 직접 | 27.1 | 1.17s | 1.23s | 1.46s |
| 1000 | vLLM + Redis | 944 | 33.8ms | 15.1ms | 1.58s |
경우의 수가 적을 때(PROMPTS=50)는 처리량이 100배 차이 났어요. 최대 지연 시간이 비슷한 걸 보면, GPU 단에서 vLLM이 처리하는 속도는 같고 캐싱된 답변을 반환할 때 이점이 생긴다는 걸 알 수 있어요. PROMPTS=1000으로 늘려도 처리량은 35배 가까이 차이 났어요. 참고로 이때도 hit rate가 98%로 높아서 성능이 크게 좋아졌어요. GCP의 Cloud Run GPU처럼 사용 시간만큼 GPU 요금이 청구되는 솔루션을 쓰고 있다면, Redis만 적용해도 비용을 아낄 수 있어요.
이 시나리오는 deterministic한 요청, 즉 같은 입력에 늘 같은 답을 내야 하는 요청을 처리할 때 효과가 있어요. Redis에서는 hash table로 O(1) 조회를 할 수 있어요. 그래서 LLM routing이나 Agent decision처럼 빠르고 일관되게 판단해야 하는 상황에서는 Redis를 쓰는 편이 훨씬 유리해요. 다만 같은 프롬프트라도 요청마다 다른 답변이 나와야 한다면, Redis 캐시가 오히려 걸림돌이 될 수 있어요. 이럴 때는 Redis key를 비즈니스 로직에 맞게 세밀하게 설정해야 해요.
LLM 채팅 환경에서도 빠를까
LLM 하면 보통 멀티턴 채팅 환경이 가장 먼저 떠오를 거예요. 이 환경에서는 system prompt와 대화 기록이 고정으로 prefill되고, 사용자 입력만 요청마다 바뀌어요. 그래서 캐시가 꾸준히 필요하면서도, 요청마다 GPU를 돌려야 하는 환경이에요.
대화 상황을 재현하려고 ShareGPT 데이터를 활용했어요. 5턴 이내의 짧은 대화 1000세션을 사용했어요.
// 코드 일부 생략
const s = SESSIONS[exec.scenario.iterationInTest % SESSIONS.length];
for (let i = 0; i < s.length; i += 2) {
  const res = http.post(
    `${__ENV.TARGET}/v1/chat/completions`,
    JSON.stringify({
      model: __ENV.MODEL,
      messages: [{ role: "system", content: SYSTEM }, ...s.slice(0, i + 1)],
    }),
  );
}
| 서버 | 요청/s | 출력 tok/s | 입력 tok/s | 평균 지연 | p95 지연 | vLLM prefix hit | Redis hit |
|---|---|---|---|---|---|---|---|
| Transformers | 0.29 | 27 | 276 | 48.2s | 1m27s | – | – |
| vLLM | 11.8 | 1,195 | 14,049 | 2.53s | 4.66s | 82.1% | – |
| vLLM + Redis | 11.9 | 1,213 | 14,144 | 2.55s | 4.53s | 82.1% | 1/836 |
Transformers와 vLLM의 처리량은 40배 차이가 났어요. vLLM의 prefix hit ratio도 82.1%로 높았어요. 멀티턴 대화 환경에서도 KV cache는 여전히 효과적이에요. 반면 Redis의 hit ratio는 836건 중 1건으로, 사실상 쓰이지 않았어요. 그런데도 Redis를 쓰지 않은 경우와 성능 차이가 크지 않은 걸 보면, Redis 자체의 오버헤드는 크지 않아 보여요.